Salesforce Data 360 怎麼用在行銷?拆解它把客服對話變成分眾名單的兩道 AI 流程
Dreamforce 2026 一場內部分享:Salesforce 怎麼用 Data 360 把 30 萬份通話逐字稿、200 萬筆客服對話,經「訊號擷取」與「主題識別」兩道 AI 流程,變成行銷可直接建分眾的名單。
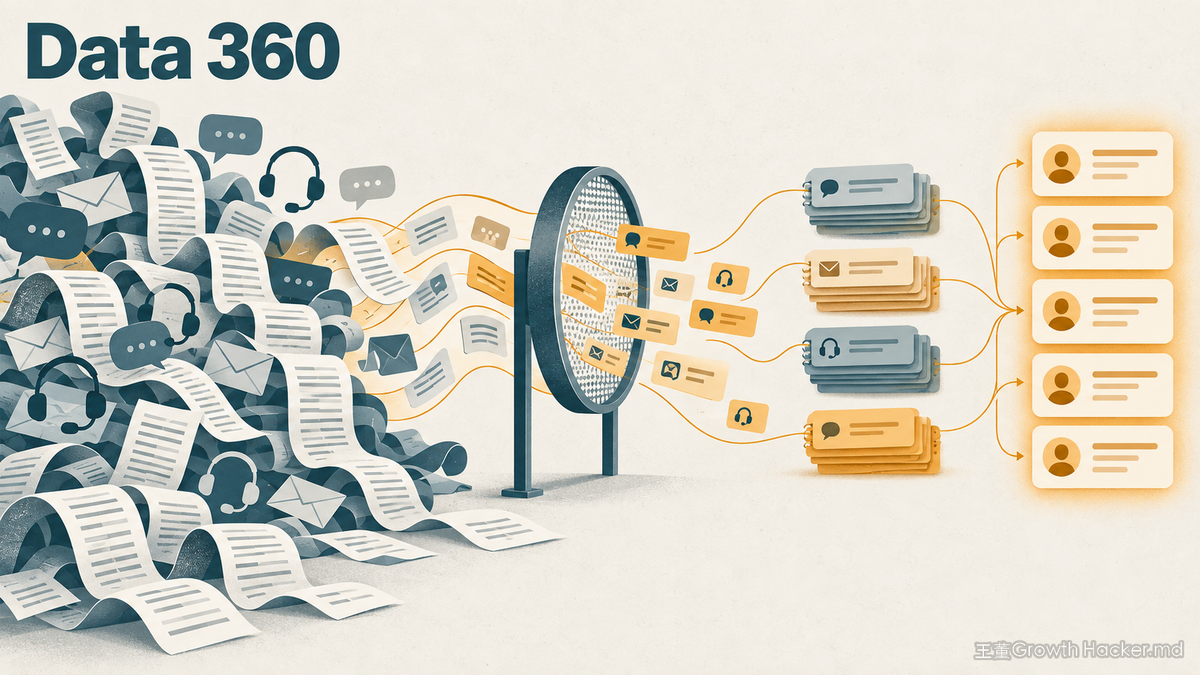
照 Salesforce Data 360 團隊在 Dreamforce 2026 台上的說法,Salesforce 內部累積了 30 萬份通話逐字稿、200 萬筆客服案件對話,往來 email 以百萬封計。
講者自己的形容是:這是公司裡最豐富的客戶情報。
問題是這些情報散在業務跟客服手上,而且全是沒人讀得完的文字。行銷部能直接用的,還是表單、廣告點擊、活動回覆。
Dreamforce 2026 有一場不到 20 分鐘的分場,叫〈Inside Salesforce: How We Use Data 360 for Marketing〉,由 Salesforce 內部的 Data 360 團隊上台,把他們自己怎麼解這題攤開來講。我在 Dreamforce 2026 七大重點 那篇只用一句話帶過 Data 360,這篇把它拆開看。
Salesforce Data 360 是 Salesforce 的企業資料與啟用平台,前身為 Data Cloud;Salesforce 於 2025 年 10 月在 Dreamforce 2025 宣布更名。
先給答案:
★ Salesforce 把對話資料接進 Data 360,在受治理的底層遮罩個資,再用兩道 AI 流程處理:「訊號擷取」把每段對話拆成痛點、異議、決策標準等訊號,「主題識別」再把大量訊號分群命名。最後行銷用這些主題直接在 Data Cloud 建分眾、啟動活動。
問題:客戶的心聲,大多不在行銷看得到的地方
講者開場先講一個觀念:客戶的意圖,大部分不是透過表單、廣告點擊或活動回覆表達出來的。
它散在三個地方:
- 業務對話:客戶的痛點、目標、反對理由
- 專業服務(導入顧問):客戶實際在導入什麼、卡在哪裡
- 客服:客戶遇到的挑戰、在意的優先順序,還有未來需求的早期訊號
這些東西各自被不同部門握著。業務知道通話裡發生什麼,客服知道問題出在哪,行銷只看到其中一塊。
這個困擾也不限於 Salesforce 內部。Salesforce 2026 年發布的第 10 版 State of Marketing 報告(調查 4,450 位行銷決策者)裡,只有 58% 的行銷人能完整取得客服資料,業務資料是 56%,商務資料是 51%;69% 的行銷人坦承,因為拿不到需要的脈絡,很難及時回應客戶。
這個「部門各看一塊」的結構問題,我在〈你每多買一個 AI 工具,客戶體驗就多斷一次〉那篇從接觸點交接的角度談過。這場議程則是從資料層下手。
那為什麼不直接把對話資料丟給行銷就好?
講者列了三個障礙:
- 全是非結構化的原始文字:逐字稿、email、紀錄,沒有欄位、沒有標籤
- 量太大:沒有人讀得完
- 有敏感資訊:對話裡夾著個資,直接開放有外洩風險
整體架構:原始對話 → Data 360 → 兩道 AI 流程 → 啟用
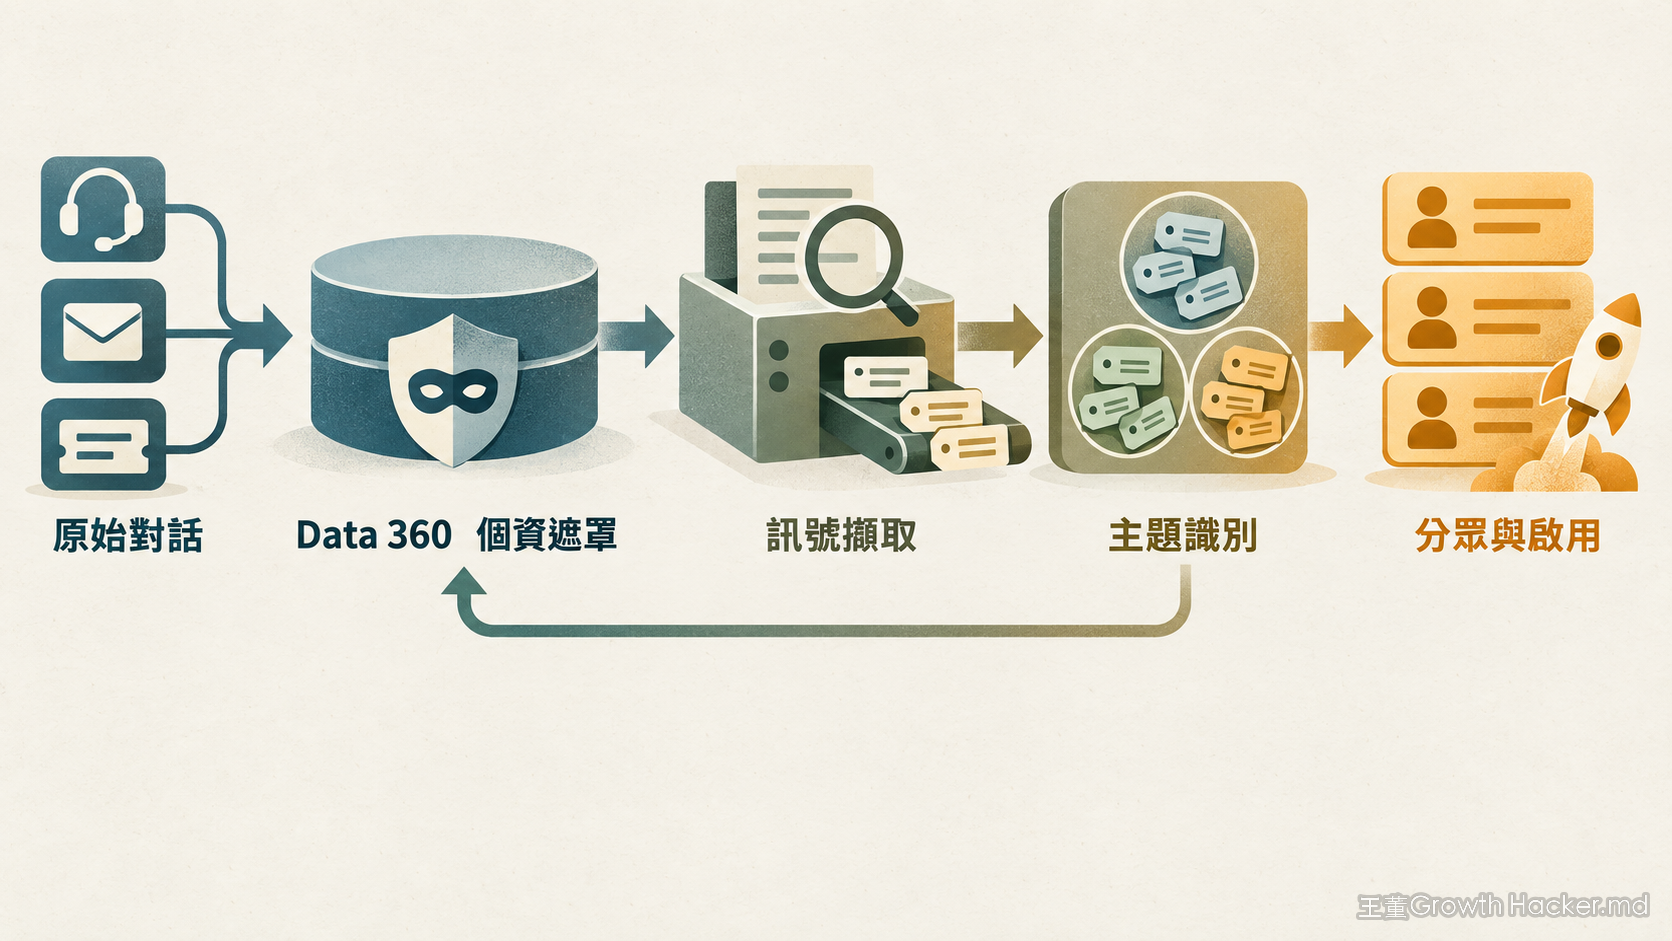
整條流程從左到右:
- 最左邊是原始來源:通話逐字稿、email、客服案件,各自描述客戶關係的一部分
- 中間是 Data 360,講者稱它為「連結層」:給 AI 產出的訊號一個受治理的資料模型,跟公司的情境資料串起來。治理直接做在底層,套用資料遮罩(data masking),講者說目的是保護個資(PII,可識別個人的資訊)不被外洩
- 兩道 AI 流程:訊號擷取、主題識別
- 最右邊是啟用:處理完的訊號跟主題回到 Data Cloud,透過資料圖譜(data graph)、向量搜尋與檢索器(retriever)讓行銷團隊取用
Data 360 在 Salesforce 整套架構裡的位置,可以回頭看 Salesforce 把整個平台變成 AI agent 基礎設施 那篇的「情境系統」。
接下來是這場最有料的部分。
第一道流程:訊號擷取,關鍵是一張「訊號定義表」
講者稱這道流程為 signal extraction,負責 demo 的講者則叫它 insight extraction,指的是同一件事:用一系列提示詞(prompt)把原始文字餵給大型語言模型(LLM),抽出可重複使用的訊號。
重點是什麼?
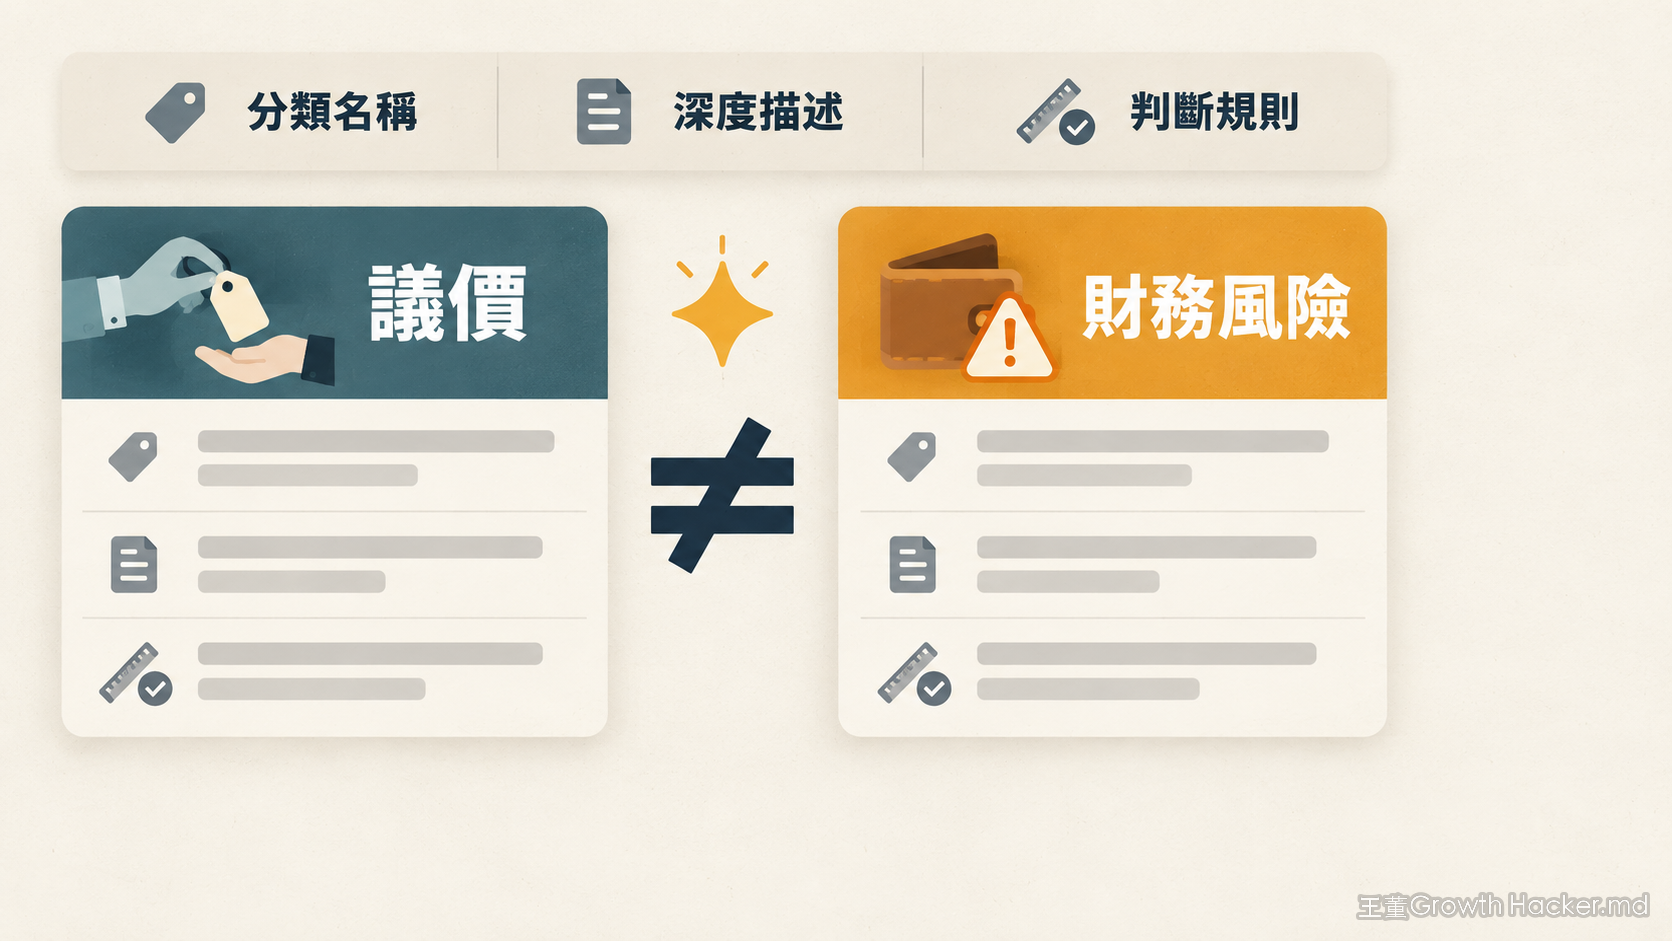
每一種訊號在抽取之前,都先被寫好定義。 講者提到三種中繼資料(metadata):
- 分類名稱:這個訊號叫什麼
- 深度描述:這個訊號到底代表什麼意思
- 判斷規則:怎麼確保 LLM 選對訊號
為什麼需要規則?講者舉的例子很實際:「議價」訊號很容易跟「財務風險」混在一起。客戶說「這個價格我們要再想想」,是在殺價,還是預算真的出問題?LLM 必須能分辨兩者,所以要用規則把界線寫清楚。
如果你問我,整場議程最值得抄的就是這一段。
打個比方,這就像郵局分信。郵遞區號規則先訂好,信才能自動分到對的格子;如果沒有規則,你只能把一整袋信倒在桌上,叫人「幫我看看大家都寫了什麼」。前者能累積,後者每次都得重來。
Salesforce 抽的訊號類型包括:
- 客戶痛點:客戶或潛在客戶想解決的問題
- 異議:對產品的疑慮,或卡住購買決策的原因
- 決策標準:客戶做採購決定時看重的條件
每則訊號都帶著出處
講者展示了一個實例:一場七月的視訊會議逐字稿,抽出了 16 則洞察。
每則洞察有兩個部分:一段簡短摘要,加上一組引用(citations),標明這段資訊來自原文哪裡。
這些洞察以半結構化的方式存放,每一則都綁著逐字稿的 record ID、客戶的 account ID,如果知道是誰講的,還會再綁 contact ID(聯絡人 ID)。
這個設計看起來不起眼。我的解讀是,它決定了後面的訊號能不能變成名單:訊號能回到某一個客戶身上,主題才能變成分眾條件。
第二道流程:主題識別,為什麼不直接叫 AI 總結
抽完訊號之後,還有一個問題。
每則訊號還是幾句話的文字。如果有一百萬則,行銷一樣沒辦法用。
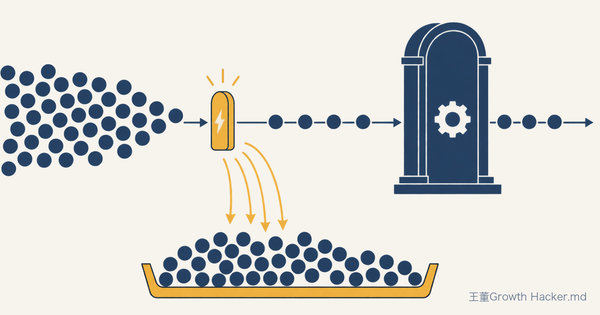
講者講得很直白:你不能把所有東西丟進 LLM,期待它準確總結幾百萬則訊號。
所以有第二道流程:主題識別(theme identification)。做法是依照每則洞察的摘要,把意思相近的訊號分在同一群,再幫這一群取名字,這個名字就是「主題」。
講者舉的痛點主題例子有:人工作業造成的營運效率問題、資料來源分散、業務得手動更新 Sales Cloud 紀錄。每則洞察會被指派一個主要主題,加一個輔助主題。
有了主題,分析才真正開始。講者列了三種用法:
- 看趨勢:哪些主題隨時間升溫
- 看產業:特定產業裡被討論最多的主題是什麼
- 看客群:把潛在客戶跟現有客戶分開,比較「潛客想解決什麼」跟「現有客戶真正卡在哪」
以前,行銷要知道客戶在想什麼,得自己去約業務跟客服開會、請人讀紀錄、整理成簡報。現在,問題變成一句查詢:哪個主題最熱、在哪個產業、是新客還是舊客。
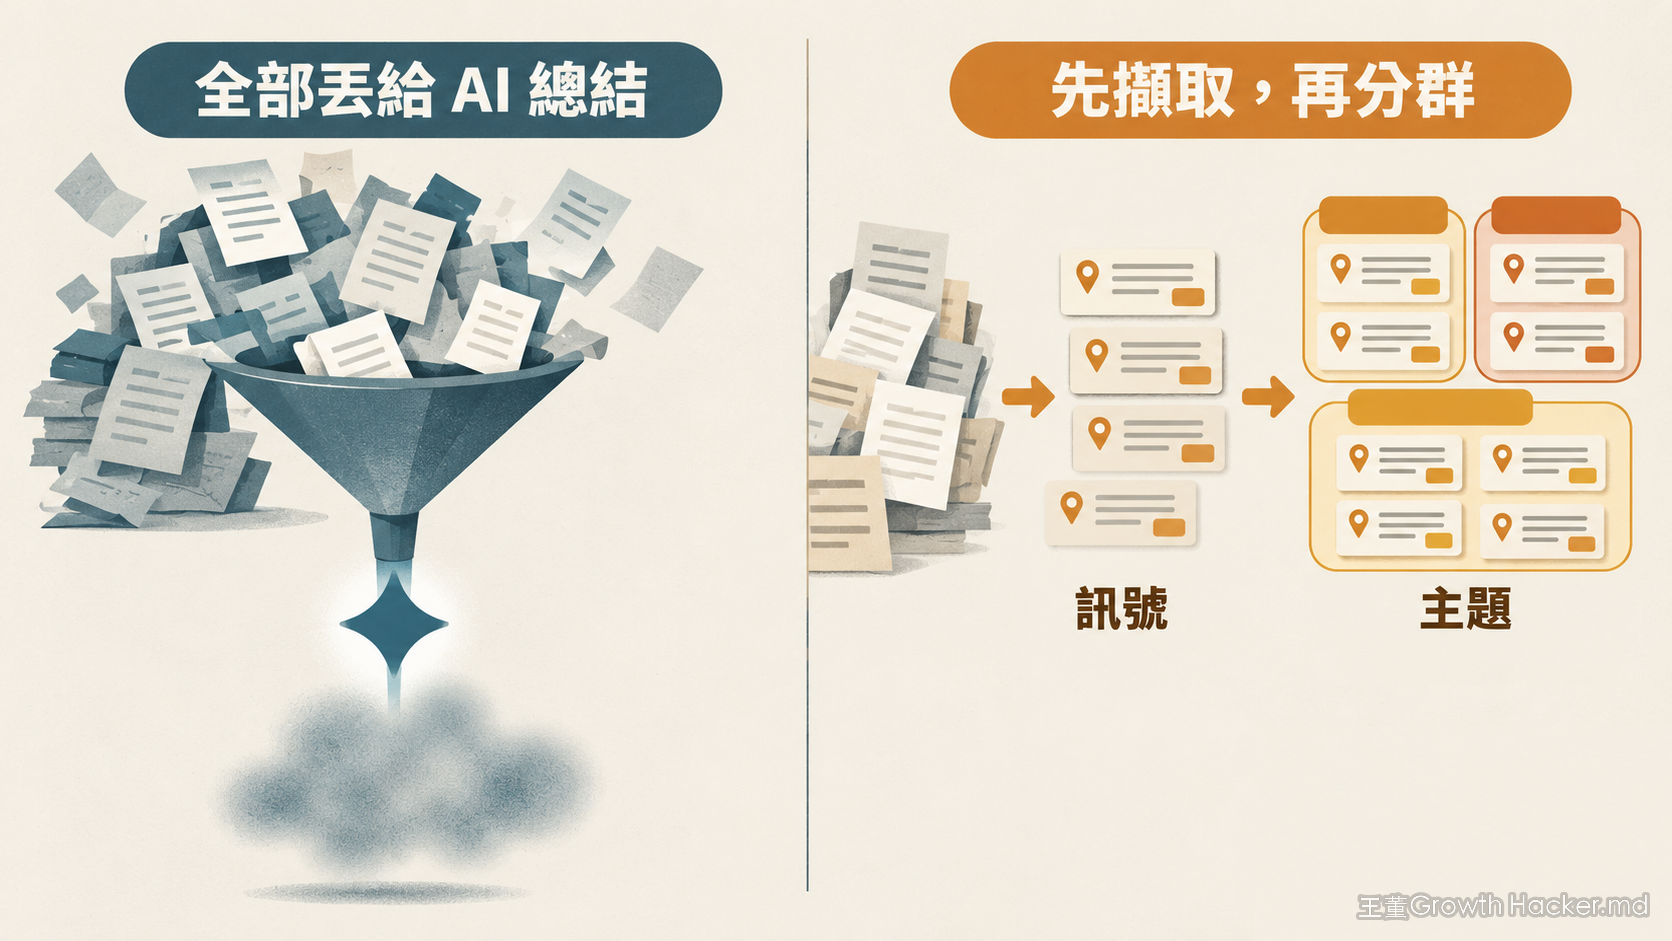
這個「先抽屬性、再分群、再命名」的骨架,不是 Salesforce 獨有。Anthropic 2024 年公開的 Clio 研究,分析大量使用者對話時用的也是同一套順序:先從每段對話抽出屬性,再做語意分群、為每群寫標題與摘要,最後組成階層。兩家公司的用途不同,順序卻一樣。我的觀察是,處理大量對話資料時,這套先抽、再分、再命名的做法很自然會被收斂出來。
行銷怎麼用:四個步驟
訊號跟主題回到 Data Cloud 之後,Salesforce 行銷團隊照四步走:
- 分析:把行銷、業務、客服的訊號放在同一份資料裡分析。介面可以是 Agentforce、Slackbot,也可以透過 Data Cloud 的 headless 能力接到其他工具。這套「不用登入後台、直接被呼叫」的思路,跟 Salesforce Headless 360 的平台方向是同一條路線
- 擬計畫:根據要鎖定的挑戰與客群,做出活動計畫
- 建分眾:把訊號關聯的帳戶、聯絡人,在 Data Cloud 建成分眾
- 啟用:計畫跟分眾都到位,直接在 Data Cloud 啟動
Demo:在 Slack 裡一路往下鑽
想像一下,你是 Salesforce 的行銷人員,週一早上打開 Slack,問 Slackbot:「最近跟客戶的互動裡,最常聽到的痛點是什麼?」
Demo 裡的答案很明確,「AI 驅動的客服優化」是最大的主題。因為每則訊號都有主題,系統可以直接算出有多少家公司在談這個痛點,畫成圖表。
接著往下問:把這個主題底下的訊號整理一下。Slackbot 會去讀原始訊號、洞察摘要跟引用,回報這些公司想做的事:用集中式知識庫、自助服務、AI 對話與案件自動分派,解決客服流程分散的問題。
主題還是太大?再往下鑽到子主題,例如「客服營運挑戰」「知識管理問題」。在「客服營運挑戰」底下,可以看到很多客服團隊仍然高度依賴人工流程:真人接電話、email、表單、基本聊天。
有了這層理解,下一步是請 Slackbot 根據手上的產品內容產出活動計畫,把痛點對到 Agentforce 的客服代理、案件自動分派等解法。
用 MCP 直接建分眾
最後一步,Demo 裡講者透過 Data Cloud 的 MCP(Model Context Protocol,讓 AI 工具呼叫外部系統的開放標準)能力,直接建出分眾。
Salesforce 在 2026 年 5 月另外發布了 Data 360 MCP Server 的開發者預覽版,讓 Cursor、Claude Code 這類 AI 工具透過 MCP 直接連到 Data 360 的 API(Salesforce Developers)。議程沒有說明 Demo 用的是不是這一套。
分眾的篩選條件就是主題與訊號。Demo 裡示範了三種篩法:
- 排除跟合規有關的主題
- 只看現有客戶
- 再進一步排除特定產業
這一步是整場的收尾,也是我認為最有意思的轉折:
客戶之聲(VOC,Voice of Customer)的終點,從一份給產品部的報告,變成一份可以直接投放的名單。
這場議程要怎麼看
兩件事先講清楚。
第一,這是 Salesforce 在自家大會上示範自家產品。影片說明欄也註明,demo 畫面中的帳戶資料都是虛構的,示範用的數字不能當真實市場數據看。
第二,講者提到 Salesforce 連續三年被評為 Gartner 客戶資料平台(CDP)魔力象限的領導者。依 Salesforce 官方頁面的說法,2026 年版 Magic Quadrant for Customer Data Platforms(2026 年 1 月發布)中,Salesforce 第三年列入領導者象限。
撇開產品,這場議程的價值在於它把「對話資料怎麼變行銷資料」的工法講得很具體。這種內部實作細節,一般產品發表會不太會講。
講者最後也提到,同一套訊號不只給行銷用,也能給業務、客服、IT 案件處理用。
至於為什麼對話文字值得這樣大費周章,可以搭配 AI Agent 時代新護城河:第一方資料比模型更關鍵 一起看。那篇講為什麼,這場議程示範怎麼做。如果你關心的是在客人開口前就認出「單一個人」,那是另一個層次的問題,見〈AI 要在他開口前就認得他〉;這場議程處理的是「一大群客人共同卡在哪裡」。
★ 這場議程可以帶走的三個重點:
► 先定義,再抽取:每種訊號要有名稱、描述與判斷規則,尤其是容易混淆的訊號
► 先抽取,再分群:不把大量文字一次丟給 AI 總結,先拆成訊號,再聚成主題
► 每則訊號都要能回到一個客戶:綁住出處、帳戶與聯絡人 ID,主題才能變成分眾名單
常見問題
Salesforce Data 360 和 Data Cloud 差在哪?
Salesforce Data 360 與 Data Cloud 是同一個產品改名前後的名稱。Salesforce 在 2025 年 10 月 13 日 Dreamforce 2025 發表 Agentforce 360 時,把 Data Cloud 更名為 Data 360,前身還用過 Salesforce CDP、Salesforce Genie 等名稱(Salesforce Ben)。Salesforce 官方新聞稿把 Data 360 定位為「給每個 agent 脈絡的統一資料層」。這場議程裡,講者兩個名字交替使用。名稱改了,不代表每項功能都在同一天跟著改變。
Salesforce 內部怎麼用 Data 360 做行銷?
把通話逐字稿、email、客服案件等對話資料接進 Data 360,遮罩個資後,用「訊號擷取」抽出痛點、異議、決策標準,再用「主題識別」分群命名。行銷依主題分析、擬活動計畫、在 Data Cloud 建分眾,最後啟用。
Data 360 這套流程怎麼把客戶之聲(VOC)變成行銷分眾?
照這場 Dreamforce 議程的示範,先從通話逐字稿、email 與客服案件中擷取痛點、異議、決策標準等訊號,再把意思相近的訊號歸成主題。每則訊號都綁著客戶的 account ID,所以行銷可以直接用主題當篩選條件建分眾,再啟動活動。這是該場議程示範的做法,不代表所有 VOC 專案都用同一套流程。
什麼是訊號擷取和主題識別?
訊號擷取是用提示詞讓 LLM 從原始文字抽出預先定義好的訊號,每種訊號都有名稱、描述與判斷規則,每則訊號附上引用與客戶 ID。主題識別是把意思相近的訊號分群並命名,讓行銷能用「主題」來彙整與篩選大量訊號。
為什麼不能把所有客服對話直接丟給 AI 總結?
Salesforce 講者的說法是,LLM 沒辦法準確總結幾百萬則訊號。先抽成結構化的訊號、再分群成主題,結果才能被計數、比較、追溯回原文,也才能拿去建分眾。
分析客服對話會不會有個資外洩的風險?
會,這也是講者列出的三個障礙之一。Salesforce 的做法是把治理做在 Data 360 底層,套用資料遮罩,降低個資在分析過程中被暴露的風險。
這套做法只能用在行銷嗎?
不是。講者提到同樣的訊號也能用在業務、客服與 IT 案件處理。
資料來源
- Inside Salesforce: How We Use Data 360 for Marketing|Dreamforce 2026(YouTube)
- Salesforce:State of Marketing 2026(第 10 版)
- Salesforce:Agentforce 360 新聞稿(2025-10-13)
- Salesforce Ben:Data Cloud 改名 Data 360
- Salesforce:2026 Gartner Magic Quadrant for CDP
- Anthropic:Clio 研究
- Salesforce Developers:Data 360 MCP Server 開發者預覽(2026-05)
協作聲明與免責
這篇文章由王董與 AI 一起整理製作完成。文中引用的第三方資料、研究或工具都會標註來源名稱;若原始出處有公開連結,會以 [來源名稱](URL) 形式附上,方便你進一步查找。若文中內容與原始出處有任何出入,請以原文為準。
內容僅供參考與學習交流,不構成任何專業、商業或投資建議,請依自身情況判斷並自行承擔行動風險。文中提及的工具功能、數據與平台政策可能隨時間異動,請以各官方最新公告為準。