你不需要每個決策都用 GPT:解碼 Jev,RLHF 發明人做了一個不會說話的 AI
前 OpenAI 研究員 Diogo Almeida 推出 TypeSafe AI 的 Jev:它不生成文字,只回傳你定義好的選項機率。用系統一/系統二拆解,把便宜的判斷層放在昂貴決策前面。
發明 RLHF 的那個人,做了一個不會生成文字的 AI。
這句話如果你讀得懂,大概已經坐直了。
Diogo Almeida 是前 OpenAI 研究員。TechCrunch 的報導形容他參與打造了 ChatGPT,並且發明了 RLHF(從人類回饋中強化學習),也就是讓 ChatGPT 變得好用的那項關鍵技術。
兩年前他離開 OpenAI,創立了 TypeSafe AI。公司安靜了兩年,2026 年 9 月才走出隱形模式(heise 報導),帶著一個叫 Jev 的模型。
Jev 不聊天。它不會寫文案、不會回你問題、不會自言自語地推理。
你給它一份輸入跟一個輸出格式,它回你一組機率。就這樣。
它的訓練方式叫 RLCD,從「校準過的決策」中做強化學習,而且 Almeida 表示是完全用合成資料訓練出來的。
例如:這封信有 90% 是垃圾郵件。這個潛在客戶有 78% 的成交可能。這張工單有 85% 該轉給技術組。
聽起來很無聊對吧?
但這件事對你的 AI 帳單,可能比任何一次模型升級都重要。
先講一個你可能沒算過的帳
你現在用 AI 做的事情,我把它分成兩類。
第一類是真的需要思考的:寫一篇文案、分析一份報表、規劃一檔活動、debug 一段程式。
第二類是只需要判斷的:這封客訴該轉給誰、這個詢價是不是認真的、這則評論要不要下架、這張圖適不適合當主圖、這個訂單要不要人工複核。
現在的問題是,這兩類你都在用同一個模型處理,付同一種價錢。
我之前解碼 Langfuse 的實驗時寫過別再燒 token,第一輪就拿走大半價值,那篇講的是同一件事的另一面:很多 AI 支出並沒有換到等值的效果。
第二類工作沒有一件需要「推理」。它們需要的是快、準、便宜,而且結果要能直接餵進你的程式裡。
你卻派了一個會寫十四行詩的模型去做這件事。
這就像你請了一位資深顧問,然後每天叫他坐在門口幫你分信。他做得來,但你每個月付的是顧問費。
系統一與系統二:一個好用的理解框架
TypeSafe 把 Jev 這個類別叫做 System One 模型,而且在官方發表文章裡直說,這個命名就是取自康納曼的《快思慢想》:
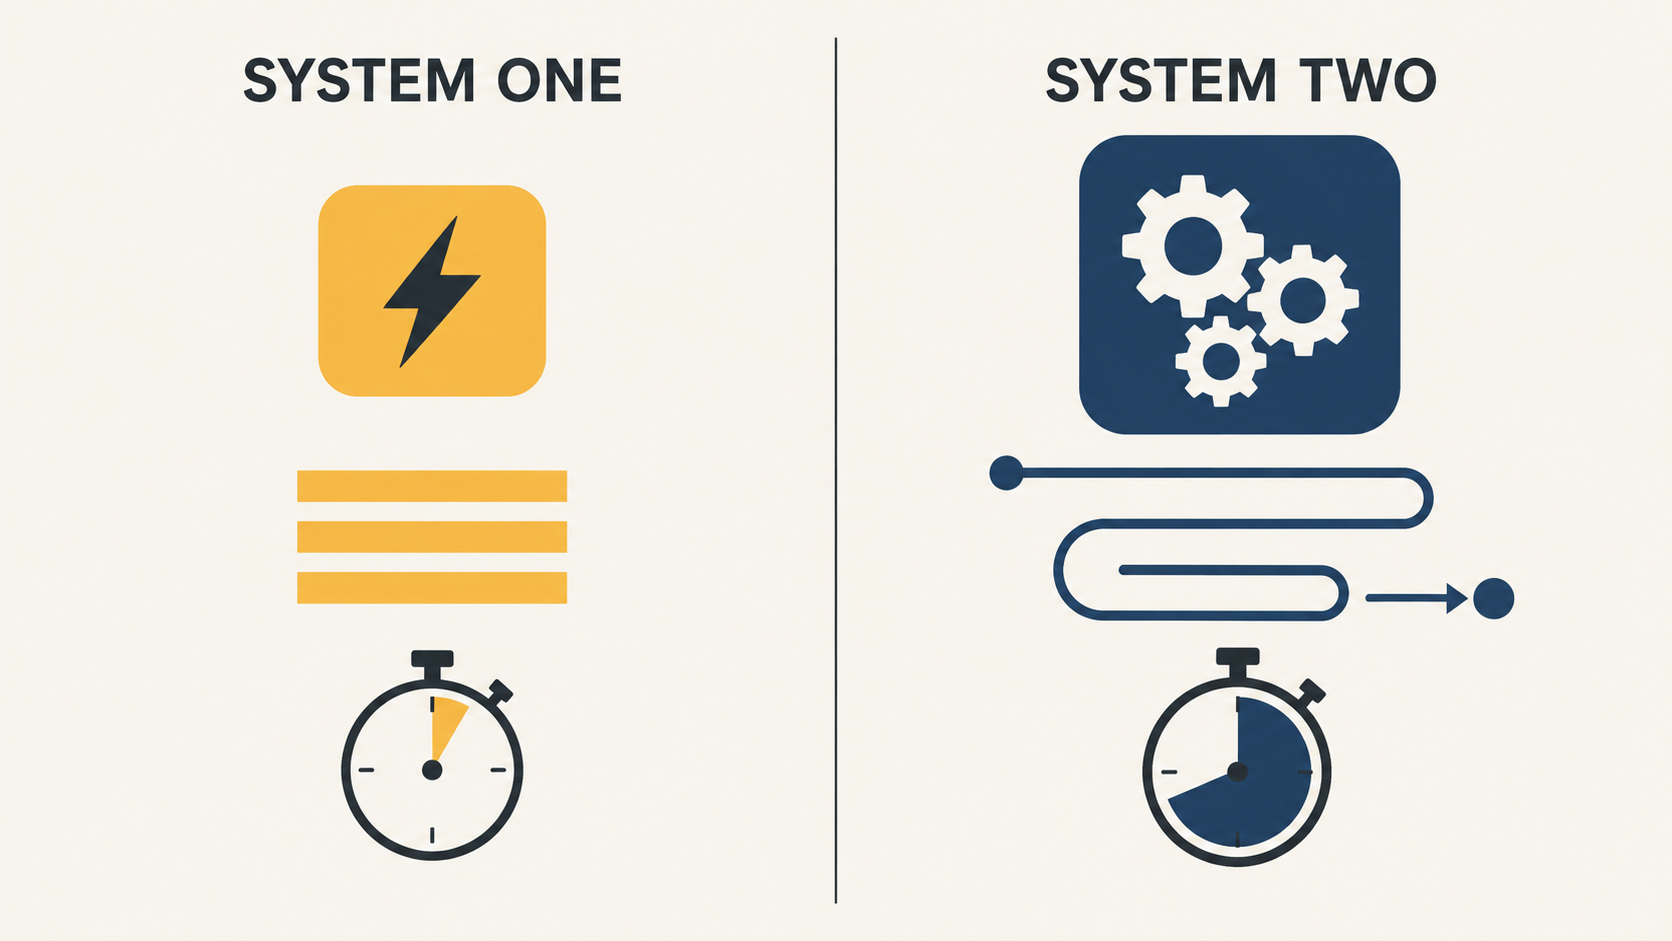
- 系統二:慢、費力、會推理。你算 17×24 的時候用的就是它。現在的 LLM 就是系統二,它會思考、會展開推理過程、會生成文字,所以它慢也貴。
- 系統一:快、自動、靠直覺。你看到一張臉立刻知道那是生氣還是開心,不需要思考。Jev 想做的就是這件事。
更有意思的是 Jev 這個名字本身。它來自 William Stanley Jevons,也就是「傑文斯悖論」的那位經濟學家:當某樣東西的使用成本下降,總消費量不會減少,反而會大幅上升。
十九世紀的煤炭是這樣,蒸汽機效率變好,煤反而燒得更兇。
他們把這個典故放進產品名字裡,等於明講了商業模式:當一次判斷便宜到幾乎免費,你不會少做判斷,你會開始在以前根本不會用 AI 的地方用它。
這是我認為整件事最值得記的一句。
回到那兩個系統。人腦絕大多數的決策是系統一做的,只有少數真的難的問題才會啟動系統二。
但我們在設計 AI 工作流程的時候,幾乎把所有事情都丟給了系統二。
這就是浪費發生的地方。
Jev 是什麼?它怎麼用 schema 回傳機率
它的用法是兩件事:定義輸入,定義輸出格式(schema)。
這段示範來自 Greg Isenberg 頻道上與 Ryan Vogle 的對談(Ryan 是 OpenCode 創始團隊成員),他用的例子最好懂。他把整封 email 物件原封不動丟進去,不做任何前處理,然後定義四個輸出:
- category:這封信屬於購物、工作、行銷、財務還是安全
- priority:低、中、高、重要、緊急(像是信用卡漏繳就該是緊急)
- spam score:不是是非題,是一個百分比
- reply likelihood:這封信有多需要你回覆
然後 Jev 回你每個選項的機率分布,總和是 100%。
注意第三項。垃圾信這件事本來就不是非黑即白,傳統分類器逼你在 true/false 之間選一個,Jev 直接給你信心分數,你可以自己決定要在哪裡畫線。
它為什麼不會幻覺
這點我覺得是整個設計裡最聰明的。
因為輸出選項是你事先定義好的,它只能在你給的選項裡分配機率,沒有空間可以編造。
LLM 會幻覺,是因為它的輸出空間是「所有可能的文字」。當輸出空間被限縮成「這五個選項的機率」,它就不可能生出你沒定義的欄位或答案。
但這裡要講精準一點:它不會編出 schema 以外的東西,不代表它判斷一定對。風險只是換了形狀,從「生成幻覺」變成「分類錯誤」或「信心分數沒校準好」。這是完全不同的除錯方式。
這也是為什麼我一直強調,決定 AI 好不好用的常常不在模型本身,而在外面那層結構(可以參考我寫的 Agent Harness 是什麼)。
這也代表回傳的東西是型別安全的資料,可以直接進你的程式碼,不用再寫一層解析去處理 AI 的自由發揮。
任何寫過「請只回傳 JSON,不要加任何說明文字」這種 prompt、然後還是被加了說明文字的人,應該都懂這個痛。
Jev 的成本與速度:哪些數字可信
先講實測。Ryan 丟了 1,700 封真實 email 進去,同時跑四種判斷,整批完成花了 18 美分,處理 420 萬個輸入 token 與 50 萬個輸出 token。
我拿公開的單價驗算了一下,420 萬輸入 token 大約就是 0.17 美元,跟他講的 18 美分對得上。
成本結構是這樣的:輸出 token 不計費,輸入是每百萬 token 0.042 美元,等於每十億 token 42 美元。
它當然還是能用百萬報價,只是價格低到可以拿十億當溝通單位。整個 LLM 產業都在比「每百萬 token 多少錢」,這裡直接把討論的刻度往上挪了一千倍。
速度方面,我選幾個具名的實測來講,比廠商自己給的倍數可信:
- Vercel 的工程師說,他們把安全指令審查的分類器從 ChatGPT Luna 5.6 換成 Jev 之後,快了 5 到 18 倍,而且準確度更高
- Bryo AI 的 CTO 講得更平衡:在他的商業郵件分類測試裡,Gemini 的準確度略高一些,但貴了 10 到 20 倍
- 官方給的延遲範圍是 70 到 500 毫秒
第二條我特別想留著。它沒有說 Jev 樣樣都贏,它說的是「差一點點,但便宜十幾倍」。多數的分流工作,這個交換划算。
影片裡還有兩個很有畫面的示範:一支長影片轉成逐字稿後,Jev 花大約 3 秒處理 110 萬 token,找出 17 個精彩片段。另一個是 Browser Use 團隊用它控制瀏覽器,從蘇黎世飛倫敦的航班,7.1 秒選完。一般瀏覽器 AI agent 做同樣的事要一到三分鐘。
電商與行銷可以怎麼用 Jev
講到這裡你應該有感覺了。我把它整理成幾個具體位置。
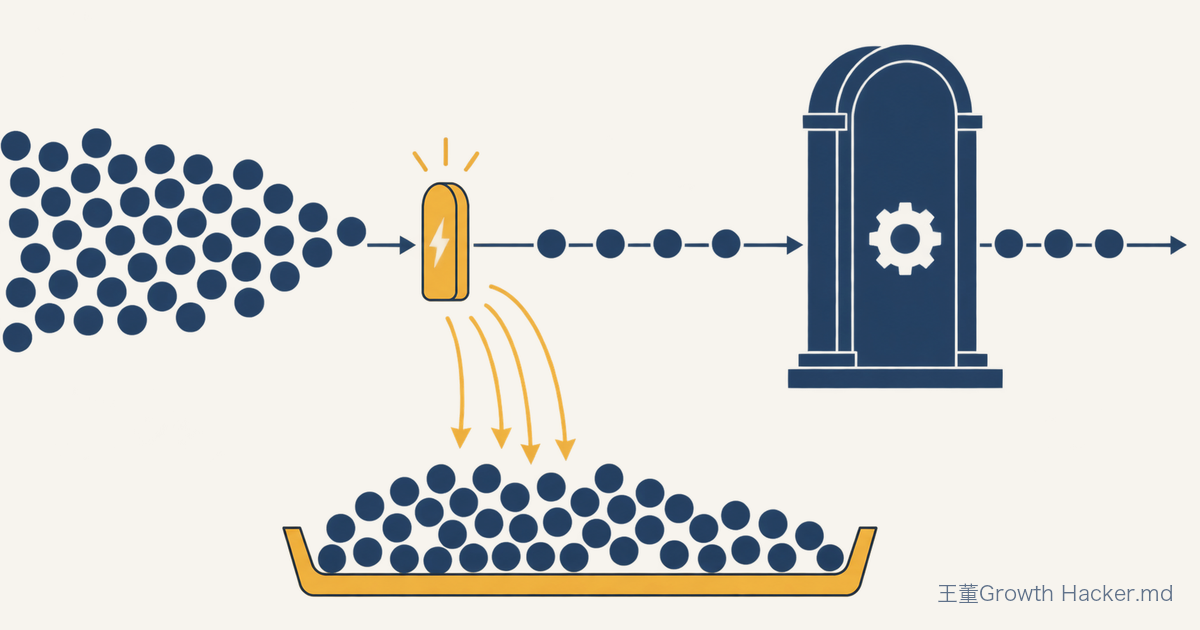
客服工單分流。進來的訊息先過一次 Jev,判斷類別、急迫性、情緒強度,再決定要丟給罐頭回覆、真人、還是升級處理。你不需要一個會寫小說的模型來做這件事。
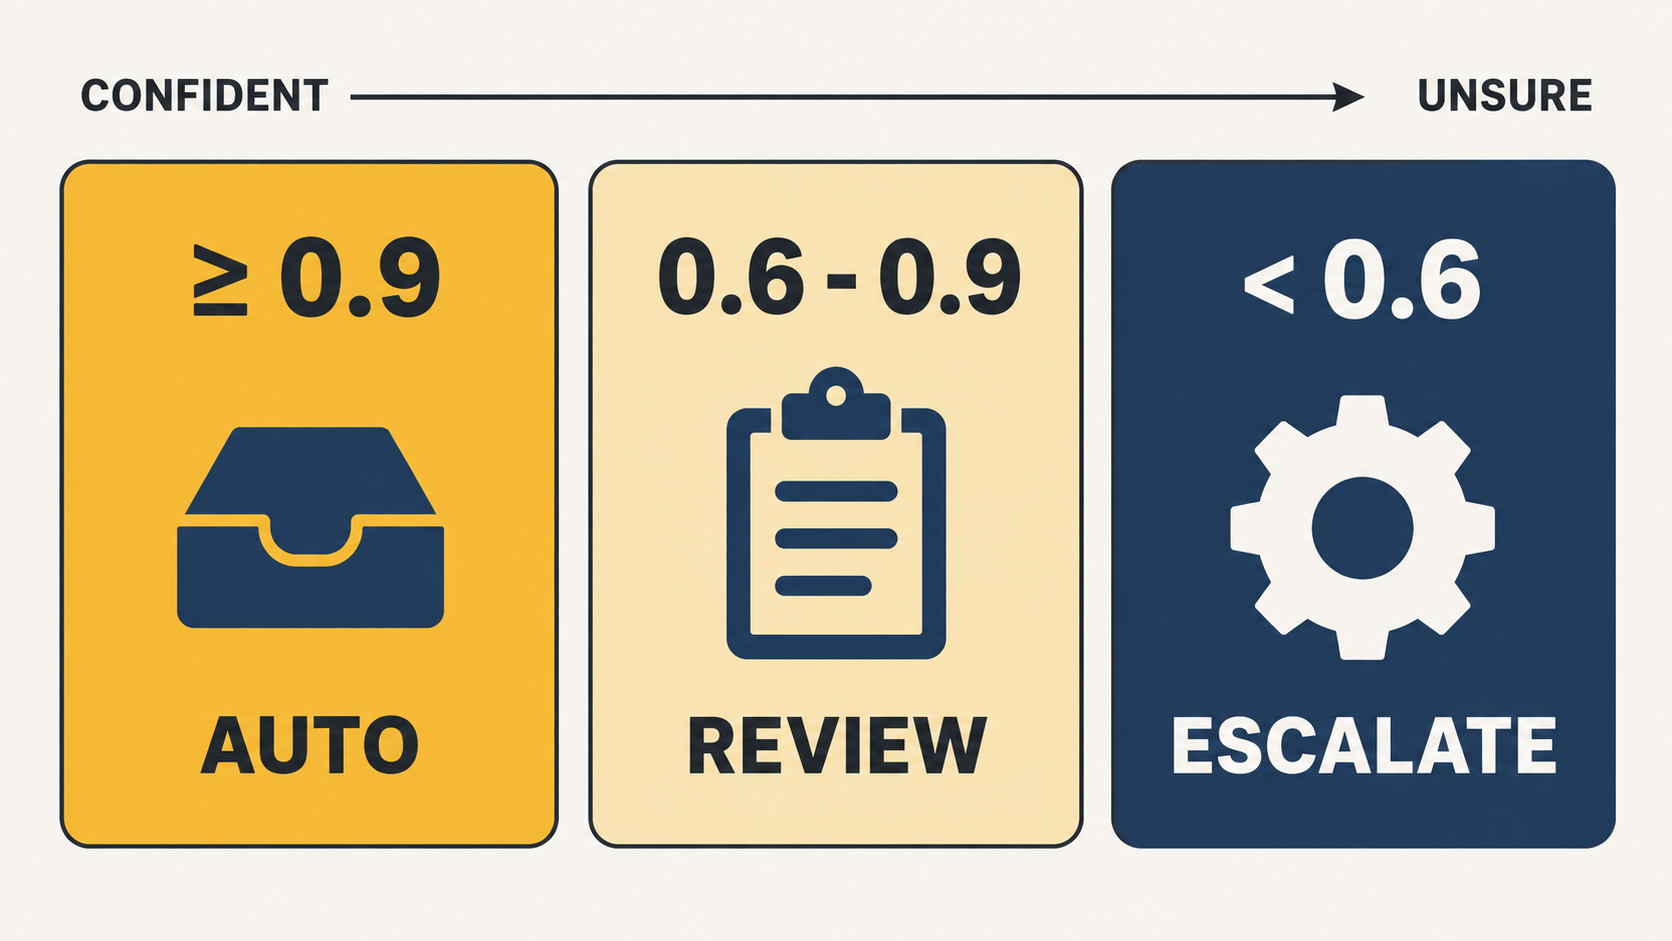
實際設定大概長這樣,你可以直接照抄去改:
| 信心分數 | 怎麼處理 |
|---|---|
| ≥ 0.9 | 直接進對應隊列,不用人看 |
| 0.6 – 0.9 | 進真人確認,但已經預填好建議分類 |
| < 0.6 | 交給 LLM 做一次摘要,或直接轉人工判讀 |
重點在第三段:低信心不是丟掉,是升級。便宜的那層負責認出「這題我沒把握」,然後才叫貴的那層出場。我寫過你的 AI 客服為什麼越用越蠢,那篇講的是記憶設計;分流則是更前面的一層。
詢價與潛客評分。B2B 或高單價商品的表單,每天進來一堆,業務時間有限。用一個分數決定誰先打電話,這正是系統一的活。
評論與留言審核。給每則留言一個風險分數,超過門檻的才進人工。這比「全部人工」跟「全部放行」都務實。而且呼應我上一篇講的:你的評論區本來就是 AI agent 會讀進去的地方。
商品資料分類。上架時自動判斷品類、屬性、適用場景。特別是那種從供應商拿到一堆雜亂資料的情況。
廣告素材初篩。一批素材先打分,低分的不用進人工評審。
看出共同點了嗎?
這些全都是「在昂貴的事情發生之前,先做一個便宜的判斷」。
先講清楚,這不是要你把 GPT 全換掉。它是在提示你:高頻、低風險、而且出錯可以回頭的判斷,可以先拆出來單獨處理。
而且它們多半卡在同一個地方:等。我拆過你公司花最多時間的流程,大部分都在等,分流這一層之所以值錢,就是因為它把「等人判斷」的時間壓掉了。
你可以把它想成一個守門員,站在你所有昂貴流程的前面。以前你請不起這個守門員,因為守門員跟裡面的顧問一樣貴。現在守門員的費用掉到零頭了。
我之前在別把模型接上廣告帳號,先問人本來在做什麼裡講過一個觀念:AI 自動化的重點不是換更強的模型,是先看清楚人本來在做什麼決定。Jev 剛好給了那些「判斷型決定」一個便宜得多的執行層。
它不適合什麼,這段別跳過
這是我覺得整支影片最誠實的部分。
Ryan 自己做了一個實驗:用 Jev 每分鐘跑一次,判斷比特幣的買賣訊號。
結果不好。
原因很清楚:這種任務需要深度推理,也需要串接即時的外部資訊,這兩件事都不是分類器的強項。
所以請把界線記清楚:
- 適合:分流、評分、路由、標記、篩選,也就是那些「在已知選項裡做選擇」的事
- 不適合:需要推理鏈、需要即時外部資訊、需要創造新內容、後果嚴重且不可逆的決策
- 也不適合:答案空間根本列不出來的任務,或者你自己都還沒定義清楚分類標準的時候。schema 要你先想清楚,這一步它幫不了你
還有一個我要提醒的:機率分數不等於正確答案。它告訴你「我 85% 覺得是這個」,不是「這個一定對」。高風險的判斷,門檻要拉高,而且該留人工複核。這跟我一直在講的原則一樣,不可逆的動作留給人。
怎麼開始
Jev 目前仍是早期存取/候補名單。影片裡提到部分使用者可以透過 Vercel AI Gateway 取用,Vercel 已經把它整合進自家的 AI 套件;實際的權限、配額與可用性,還是要以 TypeSafe 跟 Vercel 當下的公告為準。Ryan 團隊測了兩天密集使用,只花掉 5 美元額度。
實際要動手的話,我建議這個順序:
► 第一,先別急著接 API,先做一次盤點。把你團隊現在用 AI 做的事列出來,逐項問:這件事需要「思考」,還是只需要「判斷」?你可能會發現一半以上是後者。
► 第二,挑一個高頻、低風險的判斷來試。客服分流或留言審核都是好起點。高頻代表省得到錢,低風險代表判斷錯了不會出大事。
► 第三,先讓它跑影子模式。不要一開始就讓它決定,讓它跟現行流程並行跑一段時間,你只看它的分數跟人工判斷差多少。校準好了再讓它上場。
► 第四,門檻自己訂,而且分三段。高信心自動過、低信心自動擋、中間灰色地帶進人工。別只設一條線。
最後
我對這件事有興趣,不是因為 Jev 這個產品本身,畢竟它現在還是邀請制,而且是一家剛走出隱形模式的新公司。
真正值得記的是它背後那個提問:
我們是不是把太多不需要思考的事,交給了一個專門用來思考的東西?
過去三年整個產業的方向是「模型越大越好、推理越深越好」。而一個發明 RLHF 的人,跑去做一個刻意不推理、不說話、只給機率的模型,還說這是一整個新類別。
如果他是對的,那未來的 AI 工作流程不會是一個超大模型包辦一切,而是一層便宜的判斷,加上一層昂貴的思考。
便宜那層負責擋掉九成的事,昂貴那層只處理真正難的問題。
這個結構,其實跟一家管理良好的公司長得一模一樣~
協作聲明與免責
這篇文章由王董與 AI 一起整理製作完成。文中引用的第三方資料、研究或工具都會標註來源名稱;若原始出處有公開連結,會以 [來源名稱](URL) 形式附上,方便你進一步查找。若文中內容與原始出處有任何出入,請以原文為準。
內容僅供參考與學習交流,不構成任何專業、商業或投資建議,請依自身情況判斷並自行承擔行動風險。文中提及的工具功能、數據與平台政策可能隨時間異動,請以各官方最新公告為準。
文中觀點為作者個人立場,不代表所屬公司、客戶或合作夥伴之意見。