AI 原生 SDLC 是什麼?寫程式不再是瓶頸後,軟體開發六階段怎麼重寫
寫程式已經不是瓶頸,審查、部署、治理卻還在人的速度。拆解 Anthropic 的 AI 原生 SDLC 六階段:每段交出一份文件,串起來就是稽核紀錄;skills 給建議、hooks 做強制,人只在關卡上做判斷。
Claude 官網 2026 年 8 月 21 日上了一篇很長的指南,《The AI-native SDLC playbook》,作者 Louis Claxton,整理的是 Anthropic Applied AI 團隊幫客戶導入 Claude 的做法。全文英文大約要讀 40 分鐘。
它第一節的標題,就是整篇的判斷:
Code is no longer the bottleneck.(寫程式已經不是瓶頸。)
量級有多誇張?Anthropic 工程部落格 10 月的另一篇文章《Redesigning source control at Anthropic》提到,他們自家 monorepo(全公司程式碼放在同一個程式庫)每天合併的變更,2026 年 5 月平均約 2,500 次,到了 9 月已經超過 30,000 次。
程式碼產得這麼快,前後的流程呢?規劃、審查、上線,多半還是照人的節奏在走。
這份 playbook 要處理的就是這件事:把軟體開發的整套流程重新設計,讓它跟得上 agent 的速度,同時不放掉治理。這篇是總覽,六個階段各改了什麼、要交出哪份文件、人在哪裡把關,以及從哪一步開始導入。
先講結論:AI 原生 SDLC 是什麼?
AI 原生 SDLC(AI-native Software Development Lifecycle)是保留原本的控制目標、換一套執行方式的軟體開發流程。規劃、設計、開發、測試、部署、維運六個階段都嵌入 AI,每一段結束時把一份文件提交進版本控制,下一段讀它開工。人的注意力從逐行看程式,移到幾個關卡上審文件、做判斷,受監管與關鍵的程式仍保留人工審查。那一串文件,同時就是稽核紀錄。
為什麼要重寫流程:寫程式變快了,前後兩端還在人的速度
SDLC(軟體開發生命週期)是把軟體從點子帶到上線的整套流程。大部分組織都跑類似的六段,而且每一段歸不同角色:PM 寫需求、架構師做設計、工程師寫程式、QA 驗證、發布團隊上線、維運團隊盯著。段與段之間,靠文件、工單、簽核交接。
這套流程有個前提:當年最慢、最貴的環節是寫程式。PRD(產品需求文件)、估工時、資安審查,都是為了在動輒幾週到幾季的開發期間,把大家對齊。
寫程式的時間縮到幾小時之後,原文說會同時發生三件事:
- 瓶頸往開發的左右兩邊移。 規劃、審查與測試、部署,還在人的速度。
- 控制機制跟現實脫節。 人寫的程式逐行看很合理,agent 寫掉大部分 diff(程式差異)之後,逐行看就看不完。
- 治理成本上升。 例外狀況還是要排進每週或每月一次的委員會。
想像一下,一位工程師早上同時開了三個 Claude Code,中午前送出好幾個 PR(合併請求)。可是負責資安審查的,還是那兩位同事。
原文舉的正是資安的例子:資安團隊的人力是照人類產出量配置的,agent 把產出放大之後,結果只剩兩種,審查越排越長,或是沒審完就上線。受監管的組織,兩種都不能接受。
瓶頸會往下游跑這件事,站上之前用 Anthropic 自家的案例拆過(你導入 AI 之後沒有變快,因為你只是把塞車點往後推了一格)。這份 playbook 往前多走一步:既然知道瓶頸會移動,整條流程從頭到尾該怎麼重擺。
AI 原生 SDLC 跟傳統 SDLC 差在哪?
原文的定義是:保留舊的控制目標,搭配新的執行方式。流程從直線變成迴圈,每一段都嵌入 AI,段與段之間自動交接、自動觸發下一步。你在別處看到的 agentic SDLC、AI SDLC,講的是同一件事。
簡單比較一下兩端:
| 階段 | 以前靠什麼推進 | AI 原生之後靠什麼推進 | 交出的文件 |
|---|---|---|---|
| 規劃 Plan | 需求會議、工作坊、層層簽核 | 提出點子的人和 Claude 討論後直接成稿 | intent.md |
| 設計 Design | 分析師、設計師分兩段接力 | 一場 agent 對話完成,組織規範寫成 skills 自動套用 | spec.md |
| 開發 Build | 手寫程式,文件事後補 | AI 寫程式和測試,團隊知識放在 CLAUDE.md 與 skills |
plan.md、diff |
| 測試 Test | 階段交界的 QA 關卡 | 每個 session 自己驗證,評測跟著 CI 持續跑 | 測試與建置紀錄 |
| 部署 Deploy | 人工逐行審查、定期審查會議 | 多層 AI 審查,人審關鍵程式;hooks 在 AI 動手當下執行規則 | PR 與審查意見 |
| 維運 Maintain | 人盯著線上抓 bug | agent 監控,指標越界就診斷,寫回新的需求 | 事故紀錄、新 intent.md |
原文也說得很老實:大部分組織落在兩欄中間。這張表是光譜的兩端,不是及格線。
文件鏈就是稽核紀錄:整份 playbook 的骨幹
如果整篇只能記一件事,記這個。
每一段結束時,都要把一份文件 commit(提交)進版本控制;下一段一開始,就讀這份文件。六段串起來是這樣:
intent.md → spec.md → plan.md → diff 與測試 → PR 與審查意見 → 事故紀錄
前面幾段用 markdown 檔,因為產品負責人和 agent 都讀得懂、都能接著做;從開發開始,文件就變成程式碼和它的紀錄。
這一串 commit,同時回答了稽核最在意的三個問題:誰要了什麼、agent 做了什麼、誰核准的。
這就像裝修一間房子。業主需求單、設計圖、施工計畫、施工與檢驗紀錄、驗收簽名、保固報修單,每一張都有人簽、有日期,出問題時可以一路往回查。軟體開發以前也有這些東西,只是散在會議紀錄、工單留言、某個人的腦袋裡。AI 原生 SDLC 的做法,是讓每一張單都變成版控裡的一個檔案,而且下一棒直接讀它開工。
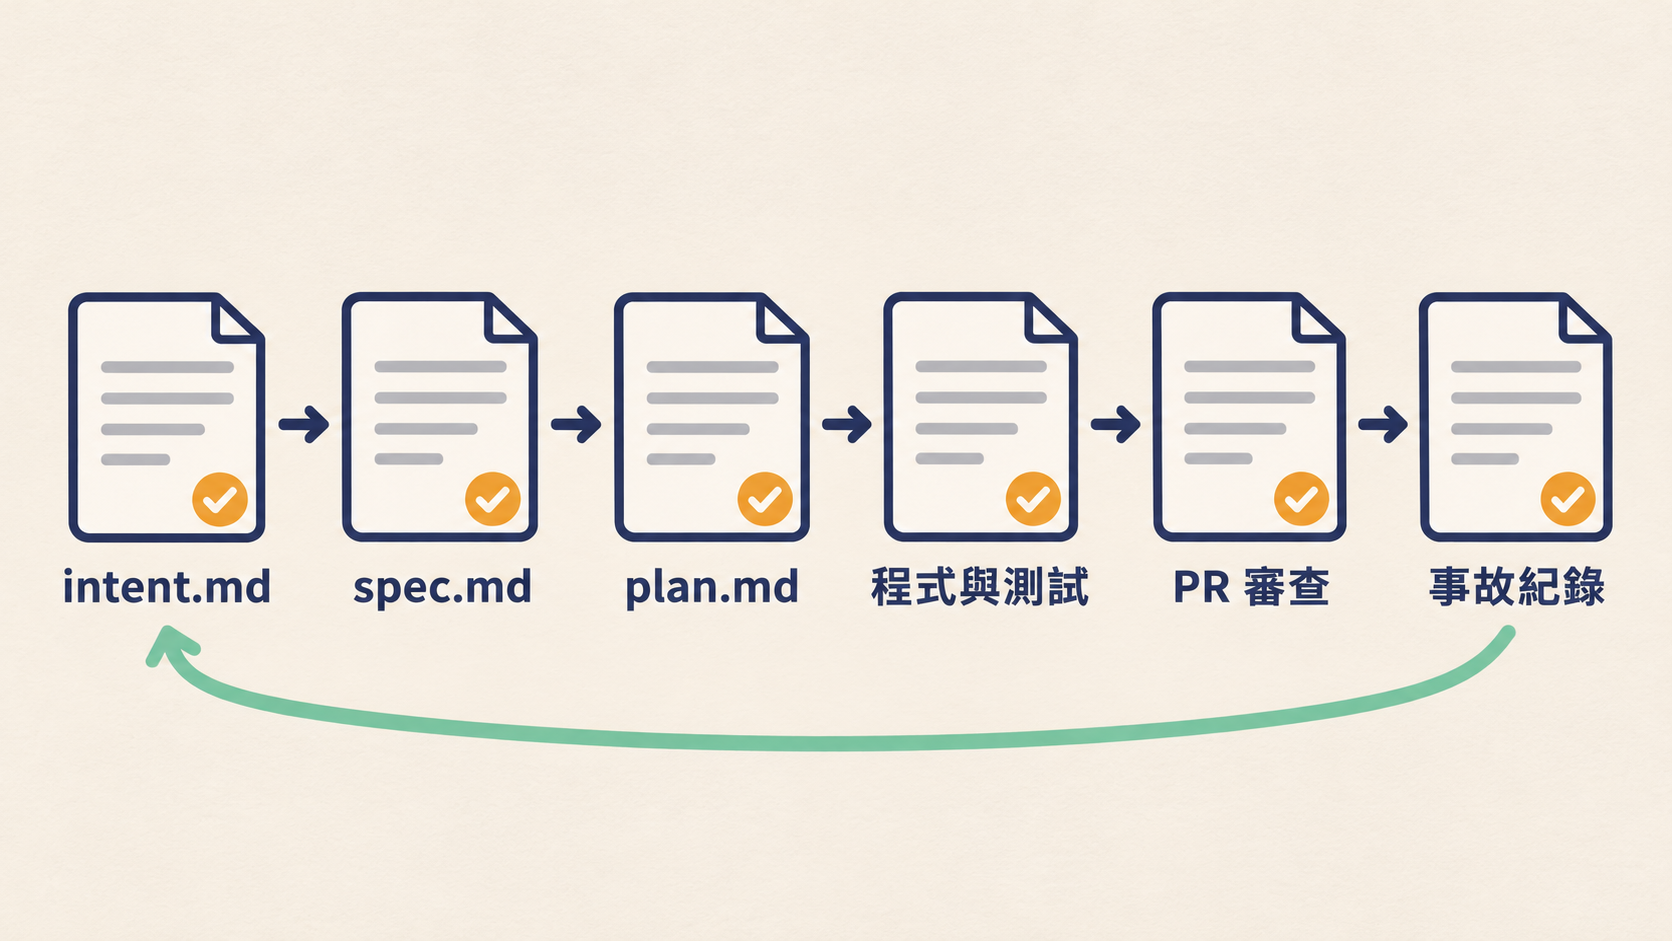
原文描述的終點,是每一份被接受的文件自動觸發下一道關卡:
intent.md被接受,觸發需求與設計spec.md核准,觸發計畫模式- PR 合併,觸發部署 pipeline
- 生產環境指標越界,寫出下一份
intent.md
一開始,每一步都是人手動下指令;慢慢地,變成文件自己接力。人的注意力集中在關卡上,看 agent 標出來的問題,不用每一段從零開始。
重點是什麼?
人沒有退出流程,人從「做每一步」換成「審每一份文件」。
AI 軟體開發流程六階段逐一拆解
每一段都用同一組問題來看:改了什麼、要準備什麼、交出哪份文件、人在哪裡把關。
1. Plan 規劃:點子不用再等人幫你寫成需求
改了什麼。 傳統流程裡,一個點子要經過 backlog、user story、估點數、refinement 會議,才有人能動手,每交接一次就離原意遠一點。AI 原生的做法,是讓提出點子的人直接跟 Claude 討論。Claude 會像分析師一樣追問範圍、使用者、限制、成功長什麼樣子,最後照組織的範本寫成 intent.md:要什麼、為什麼、有哪些限制、還有哪些問題沒答。
要準備什麼。 非工程師也能用的 Claude(claude.ai 或 Cowork)、一份大家同意的 intent.md 範本、一個有版控的存放處。單一產品最簡單的做法,是在產品的程式庫裡開一個 intent/ 資料夾。不會用 git 的人也沒關係,透過連上 GitHub 的 connector,Claude 可以代為提交。
交出哪份文件。 intent.md。原文附的範例用了一個假設情境:保險公司的客服常被問「我的理賠到哪了」,想做成網頁自助查詢。範例裡寫處理人員約三分之一通話時間在回答狀態查詢,這是範本裡的示意,不是調查數據。
人在哪裡把關。 產品負責人審稿、修正,決定接受或退回。這個決定本身就記錄成一次 merge 或一次關閉的審查。
2. Design 設計:需求和設計在一場對話裡完成
改了什麼。 需求和設計以前分兩組人接力,權責清楚,但慢,而且會走樣。現在 Claude 讀取被接受的 intent.md,一次產出需求與設計規格,套用組織寫好的 skills,把互相衝突的地方標出來。政策在寫規格的當下就被套用,不用等到幾週後的審查會議才發現牴觸。
skills 是什麼?你可以把它想成「寫成檔案的作業規範」:一個資料夾裡放一份 SKILL.md,寫清楚什麼情況要用、該怎麼做,Claude 遇到相符的任務就會自動載入。品牌規範、資安標準、法遵要求、UX 準則,都可以寫成 skill。
前端是最直觀的例子:產品負責人用 Claude Design 從 intent.md 做出設計稿,反覆修改後再交給 Claude Code 實作。這段流程站上有一篇拆得比較細(Claude Design 怎麼用?AI 做網站六步驟)。
要準備什麼。 intent.md,以及寫成 skills 的品牌、資安、法遵、UX 政策。
交出哪份文件。 spec.md,跟 intent.md 放在一起。一份記「要了什麼」,一份記「決定了什麼」。
人在哪裡把關。 產品負責人審規格,被標出的疑慮先找對應的政策負責人解決,風險高的變更再找技術主管。原文特別強調,這一步一定由人做決定,接受了 spec 才會啟動開發。
3. Build 開發:沒有核准的計畫,不准動手
開發是原文篇幅最長的一段,可以拆成五件事。
第一件:plan mode 當預設起點。 plan mode(計畫模式)下,Claude 可以讀整個程式碼庫,但在工程師核准計畫之前,不能改任何檔案。工程師把 spec.md 交給它,要它寫出實作計畫:哪些檔案要改、做事的順序、用哪些測試證明。接著反過來問它:這個改動可能弄壞什麼?哪一步風險最高?你考慮過但沒選的做法是什麼?一直改到「一個沒參與這段對話的工程師,也能照著計畫做完」為止,再 commit 成 plan.md。後面 PR 審查時,會拿實際的 diff 去對這份計畫。
第二件:auto mode 跑例行工作。 依 Claude Code 官方文件,auto mode(自動模式)會拿掉例行的權限詢問,改由另一個分類器模型在動作執行前審查,擋掉超出要求範圍的操作。原文的建議是等護欄成熟了再把它當預設:調好的 CLAUDE.md、寫進政策的 skills、會擋危險動作的 hooks、Claude 自己能跑的測試。而且只用在規格清楚、影響範圍小、測試已經覆蓋的工作上。工程師的角色,從盯著每一步,變成在一段較長的自主作業之後審成果。
第三件:CLAUDE.md 把團隊知識寫成檔案。 CLAUDE.md 是放在程式庫根目錄的說明檔,Claude 每次開工都會先讀:建置與測試指令、重要慣例、架構,以及「Claude 常犯的錯」。原文給的規則很實用:同一個錯犯兩次,就把更正寫進 CLAUDE.md;整份控制在一頁以內,因為它每次都整份讀進來,過時的內容只是在佔位置。
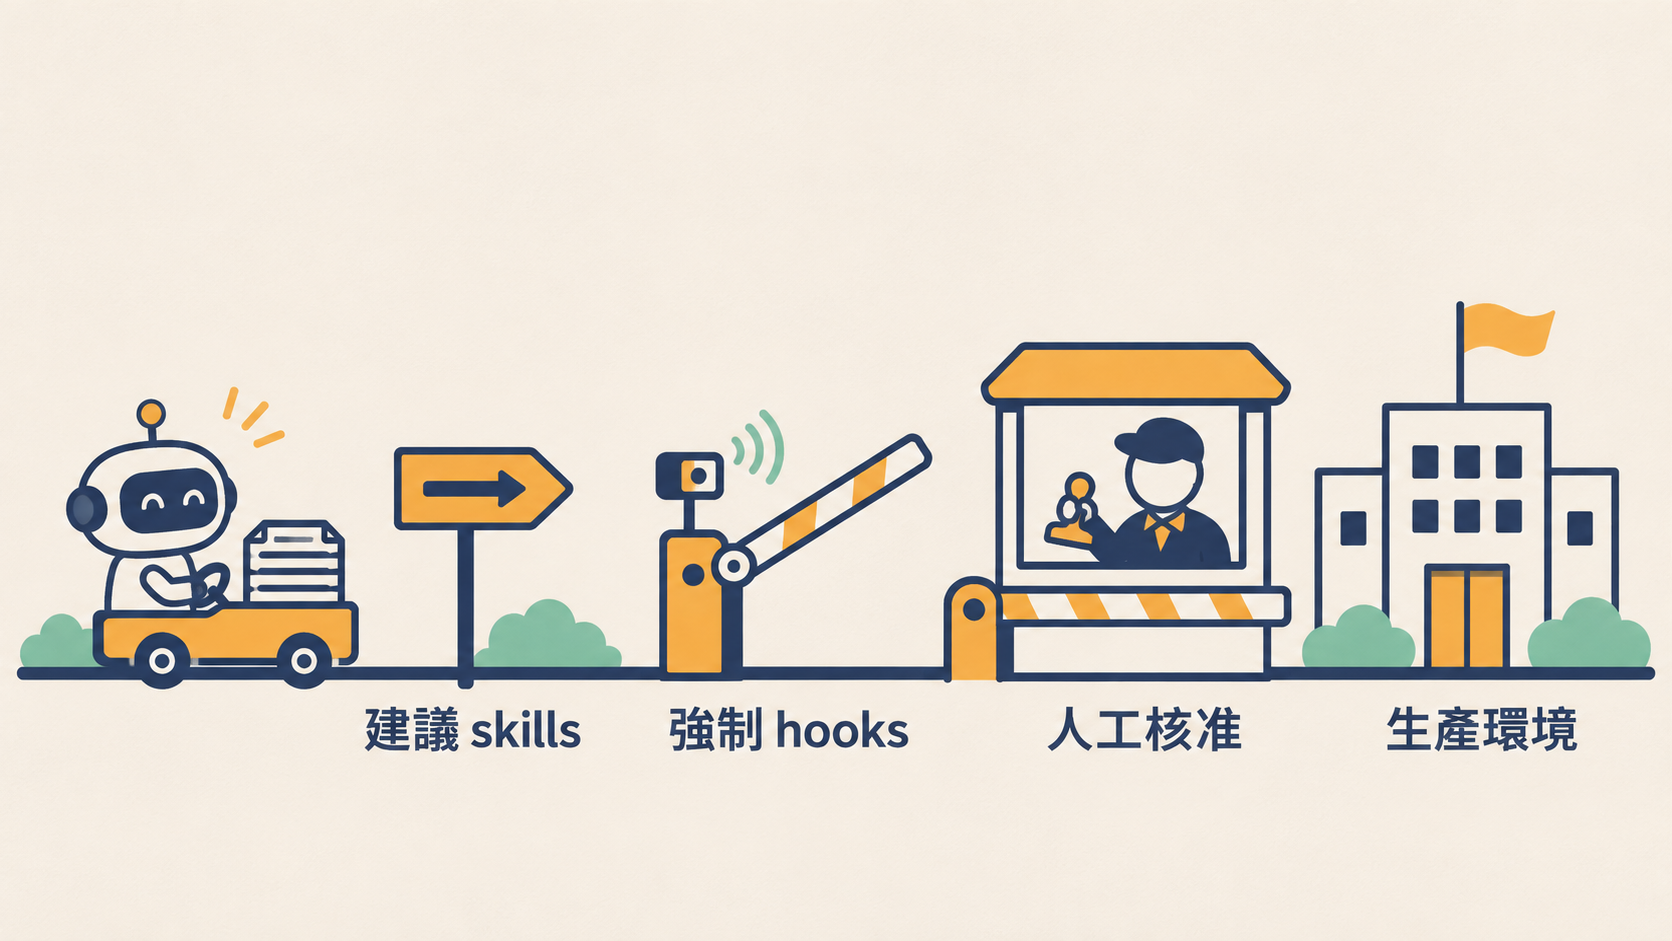
第四件:skills 是建議,hooks 是強制。 這是整份指南最值得抄下來的一個區分。
skill 讓 Claude「很可能」照政策做,但沒有任何東西逼它一定照做。hook 則是一段腳本,Claude 的動作只要符合設定的條件,就會在動作前後自動執行,可以直接擋下。原文的說法是:skill 讓違規變少,hook 讓違規接近不可能。
一條政策如果必須百分之百成立,背後就一定要有 hook,或是 PR 階段的再檢查。
開發階段的 hooks 適合做輕快的事:擋住對受保護路徑的修改、改完檔自動跑格式化和 lint(程式風格檢查)、不讓密鑰混進 diff。比較重的檢查,例如完整的測試套件,放到 commit 或 PR 階段。至於需要人按下核准的 hook,原文建議不要放在開發階段,否則人又會卡在所有平行 session 的關鍵路徑上。
第五件:平行 session 與 subagent。 一位工程師可以同時開好幾個 Claude Code,每個在自己的 git worktree(同一個專案的獨立工作資料夾,各在一條分支)處理不同任務,彼此不會蓋掉檔案。subagent(子代理)則是單一 session 裡的小幫手,有自己的 context 和工具權限,適合反覆出現的工作,例如把 app 跑起來驗證行為的 verifier。原文建議從兩三個 session 開始,上限是你審得過來的量。worktree 的實際用法,可以看站上這篇(git worktree 是什麼?讓 Claude Code、Codex 多開 agent 不打架)。
這一段還有個側欄很實際:舊系統怎麼辦?
很多公司的需求放在 Jira、設計在 Figma、變更核准走變更委員會,稽核單位也只認這些系統,換不掉。原文的原則只有一句:每一種文件,只認一個真相來源(source of truth),其他地方放副本或連結。怎麼選,看你公司現在的狀況:
| 你的狀況 | 正本放哪 | 怎麼運作 |
|---|---|---|
| 工程主導、想一次到位 | 程式庫裡的 markdown | 舊系統只引用 commit,所有紀錄同一套時間戳 |
| 稽核只認 Jira、ServiceNow 等系統 | 舊系統 | markdown 當工作副本,Claude 開工時讀、做完透過 MCP 寫回 |
| 剛開始轉換 | 兩邊都有 | 文件寫工單編號、工單寫 commit 編號,先互相連結 |
交出哪份文件。 plan.md,以及程式碼與測試的 diff。
人在哪裡把關。 一般變更由工程師核准計畫,高風險的交給技術主管或架構師;CLAUDE.md 和 skills 的修改,跟程式碼一樣走 PR 審查。
4. Test 測試:讓 Claude 先驗過自己的工作
給 Claude 一個回饋迴圈。 原文的要求很直接:永遠給 Claude 一個檢查自己工作的方法,測試、建置、截圖比對都可以。這樣送到工程師面前的東西,已經先通過一輪檢查。
具體做法有幾個重點:
- 把檢查流程包成一個指令(例如
make test),失敗就回傳錯誤。 - 給可以量化的完成目標,例如「這個測試檔全部通過」「截圖和設計稿一致」。
- 修 bug 時,先叫 Claude 寫一個會失敗的測試並 commit,再叫它讓測試通過,而且不准改測試。
- 用 hook 擋住 Claude 在修 bug 時改動測試檔,不然它可能把檢查本身改鬆。
把一個手動檢查寫成 skill、再決定綁在哪個環節自動跑,站上有一篇專門在講(Claude Code skill 教學:把手動品管檢查變成 AI 自動驗證關卡)。
持續評測跟著 CI 跑。 eval(評測)是 AI 原生版本的 QA 關卡。平台工程師從近期真實工作裡挑 20 到 50 個任務,每個寫成「prompt 加上合格條件」,放進 CI(持續整合)排程跑。而且只要 CLAUDE.md、skills、hooks 有改動,就跑一次。理由是這些設定在指揮 agent,理應接受跟程式碼一樣的回歸測試;某次 skill 修改讓通過率下降,合併前就要先審。
其中有一條規則特別值得記:
每一次生產事故,都由負責的團隊寫成一題評測,永久留在題庫裡。
交出哪份文件。 測試輸出、建置紀錄、截圖比對。這些證據由工具鏈產生,附在 PR 的檢查結果上。
人在哪裡把關。 審 PR 的 code owner(程式碼負責人)。機械性的證據已經附上,他可以專心看意圖和風險。
5. Deploy 部署:agent 可以做到生產關卡前,但過不了
這一段的原則,原文寫得最清楚:agent 可以一路做到生產環境的關卡前,但不能自己通過。
AI 進入 PR 審查迴圈。 Claude 兩邊都做:審別人的 PR,也處理別人對它 PR 的意見。技術主管在程式庫根目錄寫一份 REVIEW.md,定義要跑哪幾輪審查(bug、資安、是否符合 spec.md 與 plan.md)、什麼算 Important(重要)、什麼只是 Nit(小問題)、哪些不用報。每個 PR 都跑同一套審查,結果按嚴重度排序。
審查結果不會自己核准或擋下 PR,branch protection(分支保護)仍然要求 code owner 核准。原文的說法很直白:寫程式的 agent 沒有辦法核准自己的程式,職責分離因此保住。另外,審查抓到同一個錯第二次,也要寫回 CLAUDE.md,下一個 PR 就會抓到。
hooks 當審批關卡。 開發階段的 hook 是自動放行或擋下,不需要人;部署階段的 hook 多了一個選項:暫停,等指定的人核准。做法是工程主管會同變更管理、法遵,列出必須保留的人工關卡,例如變更簽核、發布授權、受保護路徑的修改,再由平台工程師逐一寫成 hook。團隊共用的放在程式庫的設定檔;不可妥協的放進 managed settings(由 IT 或平台團隊集中下發的設定),工程師個人關不掉。被擋下時,hook 要說清楚原因和申請核准的管道。
原文還附了一份受監管企業的 managed settings 範例:禁止讀取密鑰檔、限制對外連線、強制開沙箱、只准執行公司核准的 hooks、MCP 和外掛、設定 Claude Code 的最低版本。原文自己也提醒,這是用來調整的起點,不是照抄的建議,每多一條禁止,都是拿能力在換安全。
CI/CD 分環境給自主權。 讓 Claude 以非互動模式,在 CI/CD pipeline(自動化建置與部署流程)裡處理需要判斷的步驟。順序是先唯讀:分析建置失敗的原因、判斷測試是偶發失敗還是真的壞了、起草 changelog。再加寫入的步驟,但 agent 寫的東西一律以 PR 形式進來,沒有直接推上主分支的路。部署、查狀態、回滾,透過 MCP 包成工具,按環境限定權限。
原文的分級是這樣:
- 開發環境: agent 可以自由部署。
- 預備環境(staging): 居中。
- 生產環境: agent 準備好發布內容,由發布負責人授權,hook 強制執行這道關卡。
回滾則要是整條 pipeline 最常演練的路,因為下一段的維運會直接呼叫它。
交出哪份文件。 PR 與審查意見、核准紀錄、pipeline 日誌。
人在哪裡把關。 code owner 核准合併,發布負責人授權上線。
6. Maintain 維運:迴圈在這裡閉合
前五段都還需要有人按下開始,第六段把這一步也拿掉了。
觸發條件可以是指標越界、一張工單、頻道裡的一則訊息、或固定排程,它直接叫起 Claude,中間不經過人。Claude 診斷之後,只能走有關卡的路徑行動,並把發現寫成 intent.md,送回第一段。人負責分流和審查,不用負責啟動。
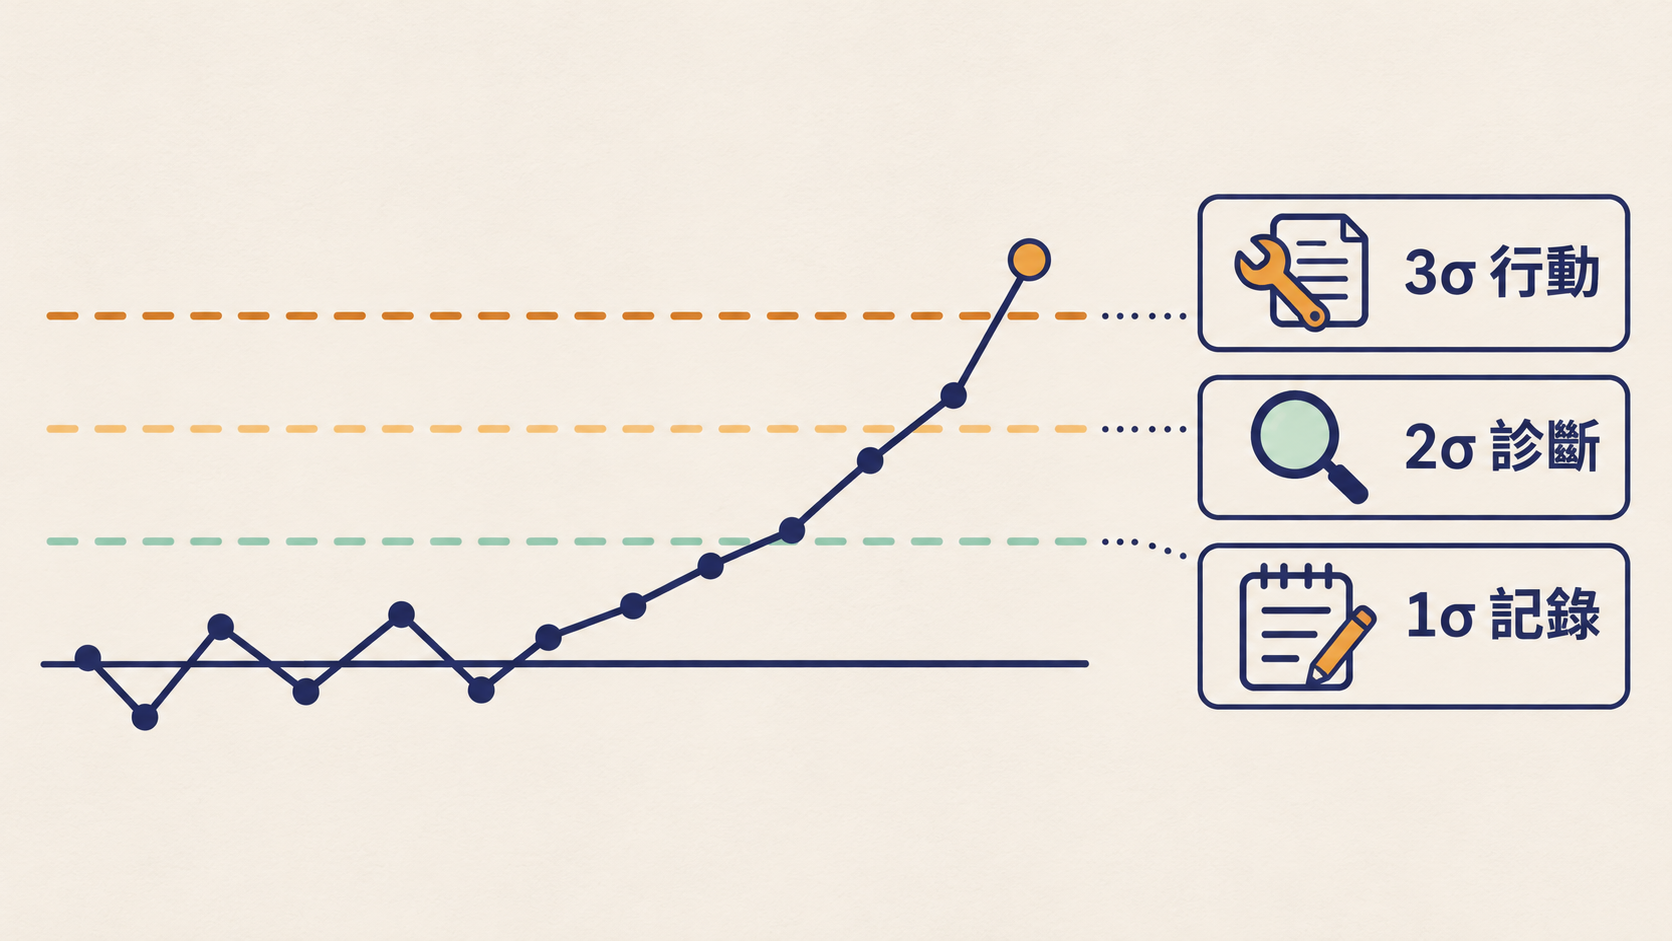
1σ/2σ/3σ 分級反應。 這裡用的是工廠品管的老方法。挑一個基準穩定的指標,例如 CI 測試失敗率、部署後的伺服器錯誤率、PR 週期時間,用滾動時間窗算出平均數和標準差(σ),畫出管制界線。偵測腳本完全是確定性的程式,有版控、有單元測試,不用任何模型。
越界之後怎麼反應,寫在一份有版控的設定檔裡:
- 1σ: 只記錄。
- 2σ: 叫 Claude 以唯讀權限診斷。
- 3σ: Claude 可以行動,但只能開 PR 送進審查關卡,或觸發事先核准的 runbook(標準作業程序),例如回滾。
原文提到偵測規則可以搭配 Western Electric rules 或類似規則。這組規則出自 1956 年 Western Electric 公司的《Statistical Quality Control Handbook》,本來是工廠管制圖的判讀法,除了「單一個點超出 3σ」,還會抓「連續好幾個點偏在中線同一側」這種慢慢漂移的訊號(規則細節可以看 Wikipedia 的整理)。放在這裡的用意一樣:不只抓突然爆掉,也抓悄悄變差。
如果你問我,這是整份指南裡最務實的設計。偵測交給確定性的程式,判斷交給 Claude,能做什麼由分級決定。就像品管員看管制圖:一個點略偏,記下來;連續偏,找人查原因;超出管制界線,照標準程序處理。差別只在於現在查原因的是 Claude,而它能走的路,事先都核准好了。
定期掃描。 原文的觀點是,一份資安掃描報告只代表「某個時間點、某個模型」下的結論。程式每週都在變,新一代模型也會找到上一代漏掉的漏洞,所以掃描應該排程跑。Claude Security 是官方的託管版本,目前以公開測試提供給 Claude Enterprise,用 Claude Mythos 等模型掃描,每個發現先驗證、附上信心評等才回報,按用量計費,記得設好花費上限。小的發現附修補建議,走 PR 審查;大的,例如架構性弱點、跨服務重複出現的問題,寫成 intent.md 從規劃重新開始。修好上線之後,同一類漏洞加進評測題庫。原文也講明,它是補強既有的靜態分析和相依套件掃描,不是取代。
Claude Tag 值班。 事故不一定從監控進來,也可能是晚上十點,Slack 頻道裡一句「這個要緊急修」。Claude Tag(公開測試中,目前在 Slack,開放 Team 與 Enterprise 方案)讓 Claude 以自己的身分加入頻道,當每起事故的第一線回應者,頻道裡任何人都可以引導它。指標回到基準後,它在討論串裡確認,並把事後檢討寫進有版控的經驗檔,給之後的調查讀。小修正一樣以 PR 進審查,大問題寫成 intent.md。
交出哪份文件。 事故紀錄,以及新的 intent.md。
人在哪裡把關。 服務負責人或值班工程師分流:現在修、排進計畫、或駁回。駁回的紀錄會拿來調整管制界線,減少雜訊。
導入順序:不用一次全上
原文附了一張相依圖,每個做法都列了前置條件。以前導入新流程,常常是開一場大會、一次切換;這份指南反過來,讓你挑沒有前置條件的先做。
可以直接開始的(零前置):
- 用
intent.md記錄點子 - 寫
CLAUDE.md - 把一條政策寫成 skill
- 給 Claude 一個回饋迴圈
- 把人工核准關卡寫成 hooks
要一層一層疊的:
- 持續評測,要先有 CLAUDE.md 和回饋迴圈。
- CI/CD 整合,要先有 AI PR 審查和 hooks 審批關卡。原文的理由是:關卡要先存在,自動化才能加速通過它。
- 維運閉環,要先有 intent.md 格式、AI PR 審查、hooks,以及演練過的回滾。
順序背後的邏輯很清楚:先把規則寫成檔案,再讓 agent 自己驗,再逐步放寬自主權,最後才讓迴圈自己轉。
至於怎麼知道有沒有效,原文每個做法都附了領先指標和落後指標,而且大部分直接從 git 紀錄和 PR 資料讀得到,不用另外建量測系統。挑幾個代表性的:
| 階段 | 領先指標 | 落後指標 |
|---|---|---|
| 規劃 | 從第一次對話到 intent.md 提交的時間(原文預期從數週縮到數小時) | intent.md 被接受進入設計的比例 |
| 設計 | intent.md 到 spec.md 的時間差 | 開發開始後,spec.md 又被修改的次數 |
| 開發 | 第一輪實作就合併的變更比例 | 每次變更的返工次數 |
| 測試 | agent 寫的變更第一次跑 CI 就通過的比例 | CI 抓到的回歸,對比生產環境才發現的回歸 |
| 部署 | 等到第一次審查的時間 | 合併前抓到的缺陷,對比漏到生產環境的缺陷 |
| 維運 | 指標越界到 intent.md 進入分流佇列的時間 | 同一類事故重複發生的次數 |
要注意,表裡的「數週縮到數小時」是原文寫的預期,不是實測數據;指南範例情境裡的數字也只是示意,不代表導入成效。
想動手的話,先做這四件事
這四件都在零前置的那一組裡,適合工程主管或平台團隊這週就排進去:
► 第一:寫好 CLAUDE.md。 在程式庫跑 /init 產生初稿,砍到一頁以內,只留建置測試指令、重要慣例、Claude 常犯的錯。訂下規則:同一個錯犯兩次,就寫進去。
► 第二:挑一條執行得不一致的政策,寫成 skill。 資安標準、API 設計慣例、品牌規範都可以。如果這條政策必須百分之百成立,同時配一個 hook。
► 第三:把驗證包成一個指令。 測試、建置、lint 各一個指令,寫進 CLAUDE.md,要求 Claude 回報完成之前一定要跑過,並且貼出結果。
► 第四:盤點必須保留的人工核准。 找變更管理和法遵一起列清單,逐一改寫成 hook;不可妥協的那幾條,放進 managed settings。
最後
以前治理靠會議和簽名,現在治理多半落在版控裡的檔案和自動執行的檢查,人工簽核只留在真正需要判斷的關卡。
這份 playbook 要你做的,是把「管」這件事寫下來:規則寫成 skills 和 hooks,判斷留在幾道關卡,每一步都留下一份文件。原文的最後一句是這樣寫的:
The loop keeps running. Human judgement stays above it.(迴圈持續轉動,人的判斷留在它之上。)
AI 寫程式的速度已經不是問題了;還在靠人工逐行審查扛治理的流程,才是。
常見問題 FAQ
Q1:AI 原生 SDLC 是什麼?和傳統 SDLC 差在哪?
傳統 SDLC 是直線流程,每一段由不同角色負責,靠會議、工單、簽核交接,控制機制假設每一步都是人做的。AI 原生 SDLC 是迴圈,每一段都嵌入 AI,結束時提交一份文件(intent.md、spec.md、plan.md 等)讓下一段直接讀取,規則寫成 skills 和 hooks 在 AI 動手的當下執行,人只在關卡上審文件、做判斷。
Q2:AI 寫的程式還需要人工 code review 嗎?
需要,但重點變了。依這份 playbook,每個 PR 先跑一套固定的 AI 審查(bug、資安、是否符合規格與計畫),人工審查保留給受監管和關鍵的程式,而且 branch protection 仍然要求 code owner 核准。人工審查的重心,從逐行挑錯移到判斷這個變更是否符合原本的意圖、風險能不能接受。寫程式的 agent 也沒有辦法核准自己的程式。
Q3:skills 和 hooks 差在哪?
skill 是建議性的控制:它讓 Claude 很可能照政策做,但沒有東西強迫它照做。hook 是強制性的控制:Claude 的動作符合設定條件時,它會自動執行,可以直接擋下動作,或暫停等人核准。必須百分之百成立的政策,要用 hook 或 PR 階段的檢查來兜底。
Q4:要從哪一步開始導入?
從沒有前置條件的做法開始:寫 CLAUDE.md、把一條政策寫成 skill、給 Claude 回饋迴圈、把人工核准寫成 hooks、用 intent.md 記錄點子。CI/CD 整合和維運閉環要等審查關卡和 hooks 都到位之後再上,因為關卡要先存在,自動化才能加速通過它。
Q5:公司的需求和變更紀錄都在 Jira,也能用這套流程嗎?
可以。原文的原則是每一種文件只指定一個真相來源:可以以程式庫為準、以 Jira 等舊系統為準(Claude 透過 MCP 讀寫),或至少讓兩邊互相連結,文件寫工單編號、工單寫 commit 編號。原文認為轉換期從互相連結開始是不錯的起點。
協作聲明與免責
這篇文章由王董與 AI 一起整理製作完成。文中引用的第三方資料、研究或工具都會標註來源名稱;若原始出處有公開連結,會以 [來源名稱](URL) 形式附上,方便你進一步查找。若文中內容與原始出處有任何出入,請以原文為準。
內容僅供參考與學習交流,不構成任何專業、商業或投資建議,請依自身情況判斷並自行承擔行動風險。文中提及的工具功能、數據與平台政策可能隨時間異動,請以各官方最新公告為準。