AI 成本怎麼算?麥肯錫:別看 token 多便宜,要算每完成一件事花多少
同等能力的 AI 推論價格跌了約 280 倍,卻有五分之一企業因為 AI 成本開始踩煞車。麥肯錫的答案是換計價單位:別算每個 token,算每完成一件事。附一條判斷 agent 值不值得的公式,用台灣電商三個情境實際算一次。
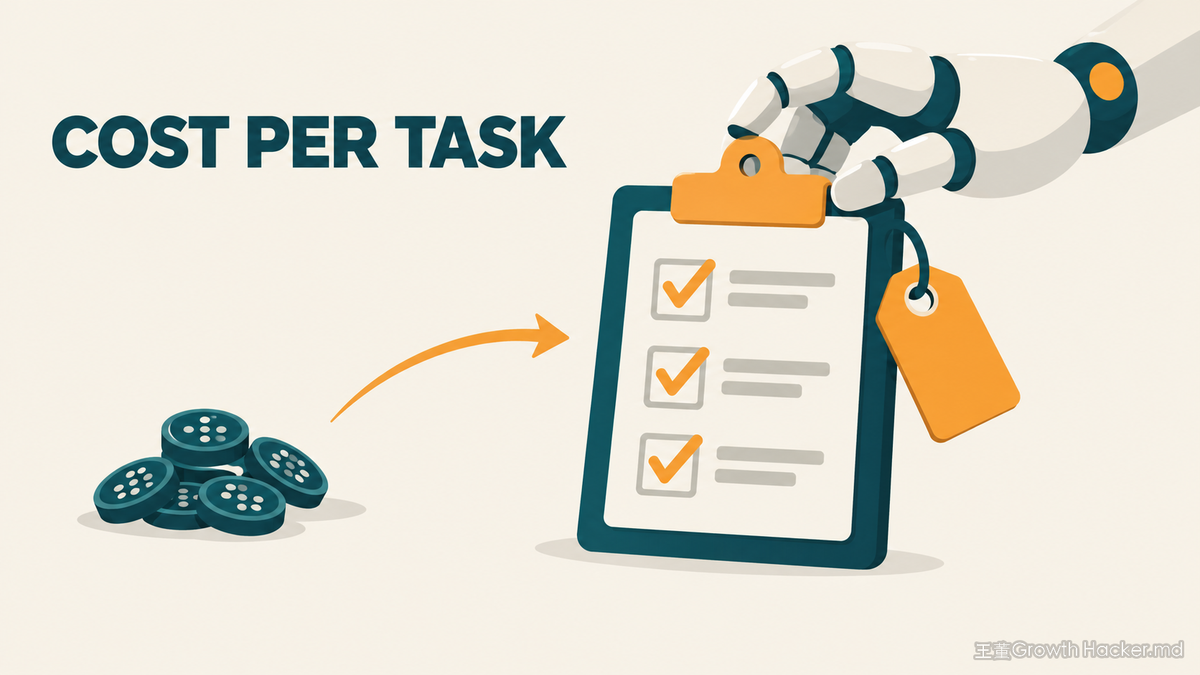
AI 成本怎麼算?如果你問我,最常見的算法從第一步就錯了:大家都在看每百萬 token 幾塊錢,但 agent 時代真正該看的是「完成一件事,總共花了多少」。這也是麥肯錫在 2026 年 9 月那場 McKinsey Live 研討會「Improving the economics of agentic AI」裡反覆講的重點。
先看一組很矛盾的數字。
根據麥肯錫在 Is that AI agent worth it? 引用的 Stanford HAI 2025 AI Index,GPT-3.5 等級的能力,推論成本從每百萬 token 20 美元降到 0.07 美元,大約便宜了 280 倍。
同一時間,麥肯錫最新的 The state of AI in 2026 調查發現:大約五分之一的受訪者說,公司已經因為 AI 營運成本(包含 token)而限制 AI 的使用。
單價跌到地板,帳單卻高到要踩煞車。
這篇把麥肯錫兩位資深合夥人 Tanguy Catlin、Lari Hämäläinen 在研討會上的說法,加上麥肯錫同一系列的書面研究拆開來看,最後用台灣電商三個常見情境,實際算一次「這個 agent 到底值不值得」。
麥肯錫 2026 AI 報告:近九成在用 AI,高績效者只有 6%
先交代背景,這組數字只是開場。
麥肯錫 The state of AI in 2026 在 2026 年 8 月發布,調查 97 個國家、1,719 位受訪者:
★ 近九成組織至少一個職能定期使用 AI,44% 說 AI 正在全企業規模化(去年 38%)
★ 80% 說 AI 提升了個人生產力,但只有 37% 說 AI 對公司 EBIT(息稅前利潤)有正向貢獻,跟去年差不多
★ AI 高績效者(AI 貢獻至少 5% EBIT、且自評價值顯著)只占約 6%
★ 28% 的組織把超過一成的資訊與通訊總預算花在 AI,60% 預期明年還要加碼
個人很有感,公司帳上沒感。錢一直加,結果沒跟上。
麥肯錫給的解法有很多層,這篇只挑最實際、你明天就能用的那一層:成本怎麼算。
為什麼 AI 越便宜,帳單越貴?
研討會主持人 Lucia Rahilly 直接問了這個悖論。綜合兩位講者的回答和麥肯錫的書面研究,原因可以濃縮成三個。
一、用量的成長,遠遠超過單價的下跌
以前你用 AI 是聊天:問一句、回一段。現在你用的是 agent:它自己拆任務、查資料、呼叫工具、寫完再檢查。
麥肯錫在 Is that AI agent worth it? 裡寫到,agentic 任務消耗的 token 大約是一般聊天或單輪推理的 1,000 倍,原因之一是模型本身不記事,agent 每走一步都要把前面的脈絡重新送一次。Anthropic 自己公布的數據也是同一個方向:在他們的多 agent 研究系統裡,單一 agent 大約用掉聊天的 4 倍 token,多 agent 系統大約 15 倍。
這兩個數字的比較基準不同,不能直接相乘,但方向很清楚:用量成長的速度,足以把單價下跌吃掉。
另外,Lari Hämäläinen 在研討會中表示,商業模型廠的推論毛利率過去一年大約從 35-40% 拉到 60% 中段,部分 API 業務超過 80%。換句話說,成本降下來的好處,不會全數回到你手上。
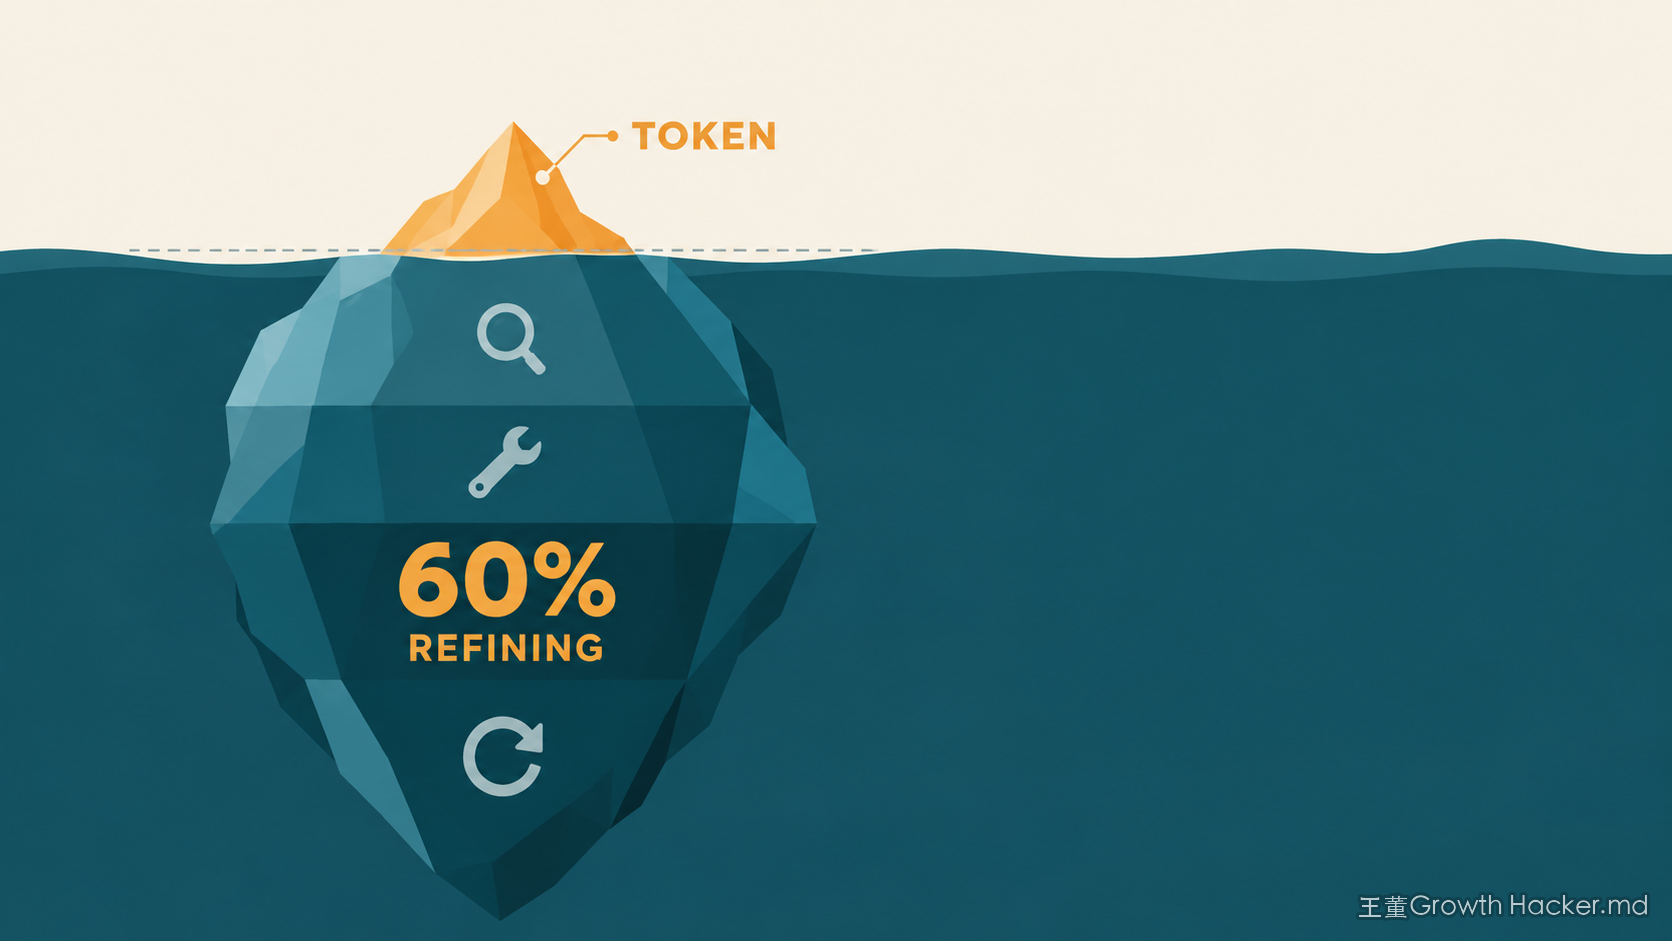
二、錢主要花在「改」,不是花在「做」
這是我覺得整場最值錢的一句觀察。
麥肯錫在書面研究中引用的數據指出,一個 agentic 任務大約有六成成本,是花在答案產出之後的檢查、修正、再驗證。第一版答案其實很便宜,貴的是後面那一輪又一輪的「再改一次」。
三、同一件事,每次的花費可以差到 30 倍
Lari Hämäläinen 在研討會上把它稱為 agent 的「自然法則」:同一個任務交給 agent,因為它每次走的路徑不同,成本是一個機率分布,不是固定單價。麥肯錫書面引用的程式任務資料顯示,不同次執行的成本可以差到 30 倍。
想像一下,你的客服 agent 平常處理一張退貨單的成本很穩定,但雙 11 隔天湧進一批訂單編號打錯、照片糊掉、一張單問三件事的客訴,agent 開始反覆查單、重試、繞路。你用「平均成本」編的預算,會在最忙的那幾天被長尾整個吃掉。
更麻煩的是,怎麼搭 agent 也會放大差距。單一 agent 還是一群 agent 分工?呼叫工具時走 MCP(Model Context Protocol,讓 AI 呼叫外部工具的協定)還是直接打 API?Lari Hämäläinen 在研討會中表示,這類系統設計的選擇,成本可以差到大約 10 到 20 倍。
AI 成本怎麼計算?算每完成一件事的總成本
麥肯錫的答案很直接:衡量單位要換。寫成算式大概是這樣:
每件任務成本 =(模型費+人工驗證+失敗重做+固定成本分攤)÷ 完成件數
在 Is that AI agent worth it? 裡,他們寫得很明白,治理的單位是「完成的業務成果」,不是 token、不是模型呼叫次數。文中也引用了 AI 成本監控新創 Pay-i 執行長 David Tepper 的一句話:"Tokens are not value; tokens are the bill."(token 不是價值,token 是帳單。)
這就像從看油價,進化到看每一趟運費。
你經營物流不會只盯著每公升油多少錢,你看的是每送一件貨的總成本:油錢、司機工時、退件重送、客訴處理全部算進去。油價便宜一塊錢,但如果路線繞、退件多,每件運費還是會變貴。
麥肯錫另一篇 Where AI agents pay off 給了一個很具體的數字:在銀行的客服 agent 案例裡,token 費用只占 agent 變動成本的 20-25%,人工監督占了 70-75%。同一篇也試算,銀行開戶流程改成 agent 協作後,每位客戶的完成成本可以從大約 50-150 美元降到 10-30 美元。
重點是什麼?
你以為 AI 的成本是模型費,其實大頭常常是「人在後面幫它檢查和收拾」的時間。
一條公式:這個 agent 值不值得用?
研討會上,Lari Hämäläinen 給了一個他自己也承認是簡化版、但非常好用的判斷法:
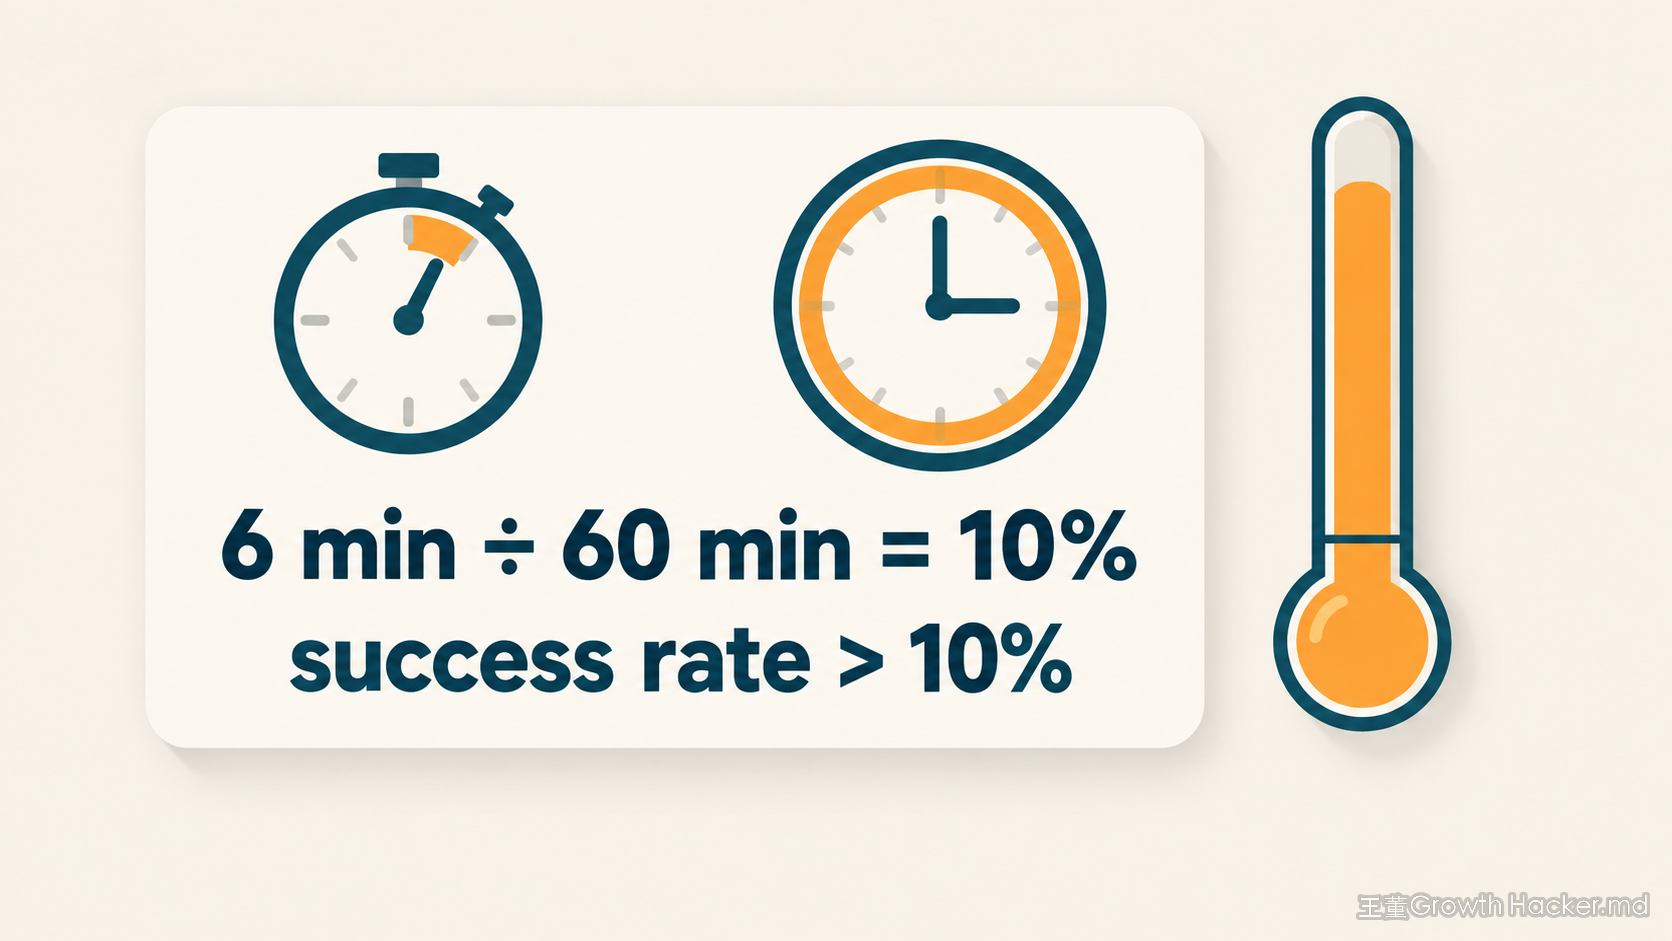
當 agent 的成功率,明顯高於「驗證時間 ÷ 人工自己做的時間」,就值得交給 agent。
他的例子是:寫一段程式你自己要 1 小時,但檢查 agent 寫的版本只要 6 分鐘。6 分鐘除以 60 分鐘是 10%,所以只要 agent 的成功率明顯高於 10%,就值得讓它先試。
這條公式的邏輯其實很樸素。你每次都得花 6 分鐘驗證;成功了,你省下 60 分鐘;失敗了,你就自己重做。只要成功的機率夠高,期望上就是賺。
放到台灣電商,我們用三個常見情境算一次(以下時間都是假設值,請換成你自己的數字):
| 情境 | 人工自己做 | 驗證 agent 成果 | 門檻(驗證 ÷ 人工) | 判讀 |
|---|---|---|---|---|
| 蝦皮、momo 上架的商品頁文案 | 40 分鐘 | 4 分鐘 | 10% | 門檻低,多數情況值得一試 |
| 每週廣告成效週報 | 3 小時 | 30 分鐘 | 約 17% | 值得,但驗證要有固定檢查表 |
| 客服退換貨判定 | 6 分鐘 | 4 分鐘(回頭對訂單、照片、對話) | 約 67% | agent 成功率要很高才划算,而且錯一次代價大 |
你會發現,同樣叫「導入 AI」,第一個跟第三個的難度完全不同。
商品頁文案的驗證很快,看一眼就知道對不對;退貨判定的驗證幾乎跟自己做一樣久,agent 的成功率就必須逼近七成才打平。這還沒算上 Tanguy Catlin 在研討會上特別補充的那個隱藏成本:agent 一旦出錯,收拾殘局的成本可能非常高。退錯一筆款、回錯一則客訴,影響的是客人,不是那幾分鐘。
所以公式算出來的門檻越高,你越要謹慎。
另外要提醒,這條簡化公式沒有把模型費和錯誤損失算進去。把下一段商品頁試算的模型費加進去,好模型的打平門檻大約變成 12.5%,便宜模型大約 10.5%,差距不大,真正拉開距離的是成功率。
便宜模型為什麼常常更貴?算給你看
Tanguy Catlin 在研討會中說,他們常看到企業做出錯誤取捨:為了省錢選了便宜模型,卻沒意識到高品質模型多付的錢,常常完全值得。
這件事做過工廠的人一聽就懂:原料單價便宜一點,良率掉了,重工和報廢的成本會把省下的錢全部吃回去。
我們把上面的商品頁情境,加上模型費,做一個假設試算:
★ 任務:1,000 個商品頁文案
★ 人工自己寫一頁 40 分鐘,驗證 agent 版本 4 分鐘,失敗就人工重寫
★ 假設人力成本每小時 NT$300
★ 好模型:成功率 70%,每頁模型費 NT$5(含重試)
★ 便宜模型:成功率 50%,每頁模型費 NT$1
| 方案 | 人工時間 | 人力成本 | 模型費 | 合計 |
|---|---|---|---|---|
| 全部人工 | 40,000 分鐘 | NT$200,000 | 0 | NT$200,000 |
| 好模型 | 驗證 4,000+重寫 12,000=16,000 分鐘 | NT$80,000 | NT$5,000 | NT$85,000 |
| 便宜模型 | 驗證 4,000+重寫 20,000=24,000 分鐘 | NT$120,000 | NT$1,000 | NT$121,000 |
模型費省了 NT$4,000,總成本多了 NT$36,000。
這就是只看 token 單價會看漏的地方。
真正的槓桿:先把驗證時間砍半
同一個試算再往下推一步,你會看到一個更有意思的結果。
如果你把驗證時間從 4 分鐘壓到 2 分鐘,1,000 頁就省下 2,000 分鐘,約 NT$10,000。這筆錢,是好模型整批模型費 NT$5,000 的兩倍。
很多時候,最大的省錢槓桿是驗證時間,不是模型單價。
驗證時間怎麼壓?幾個方向:
► 叫 agent 用固定格式交件:品名、規格、賣點、禁用詞檢查各一欄,驗證的人掃欄位,不用通篇讀
► 驗證清單寫死:價格、規格、法規用語(例如食品、化妝品不能寫療效)三項必查,其餘抽查
► 讓 agent 自己附上「我不確定的地方」,人只看那幾行
這跟麥肯錫在 Where AI agents pay off 的建議一致:與其只在模型選擇和 token 上打轉,更有效的做法是重新設計流程,降低例外率、簡化需要昂貴人工介入的審核。我之前在導入 AI 之後瓶頸往後推一格那篇也寫過同一個現象:AI 讓產出變快之後,塞車點常常就移到了驗證那一站。Anthropic 自家的就業研究報告也看到同一個訊號:agent 產出多到員工讀不完,人的注意力反而成了最缺的資源。
還有一個台灣團隊特別要注意的點:麥肯錫提到,非英文文字會被切成更多 token,同樣的意思,某些語言就是比較貴。麥肯錫沒有量化繁中會多多少,但你的 prompt 和工具回傳的內容越冗長,這筆額外成本就越容易累積。
30 倍的長尾:給每個 agent 一條停損線
回到那個 30 倍。
成本是分布,不是單價,所以只編平均預算一定不夠。麥肯錫在 Is that AI agent worth it? 裡給 CEO 的要求很硬:沒有任何自主系統應該在沒有明確任務、預算和停止規則的情況下運作。
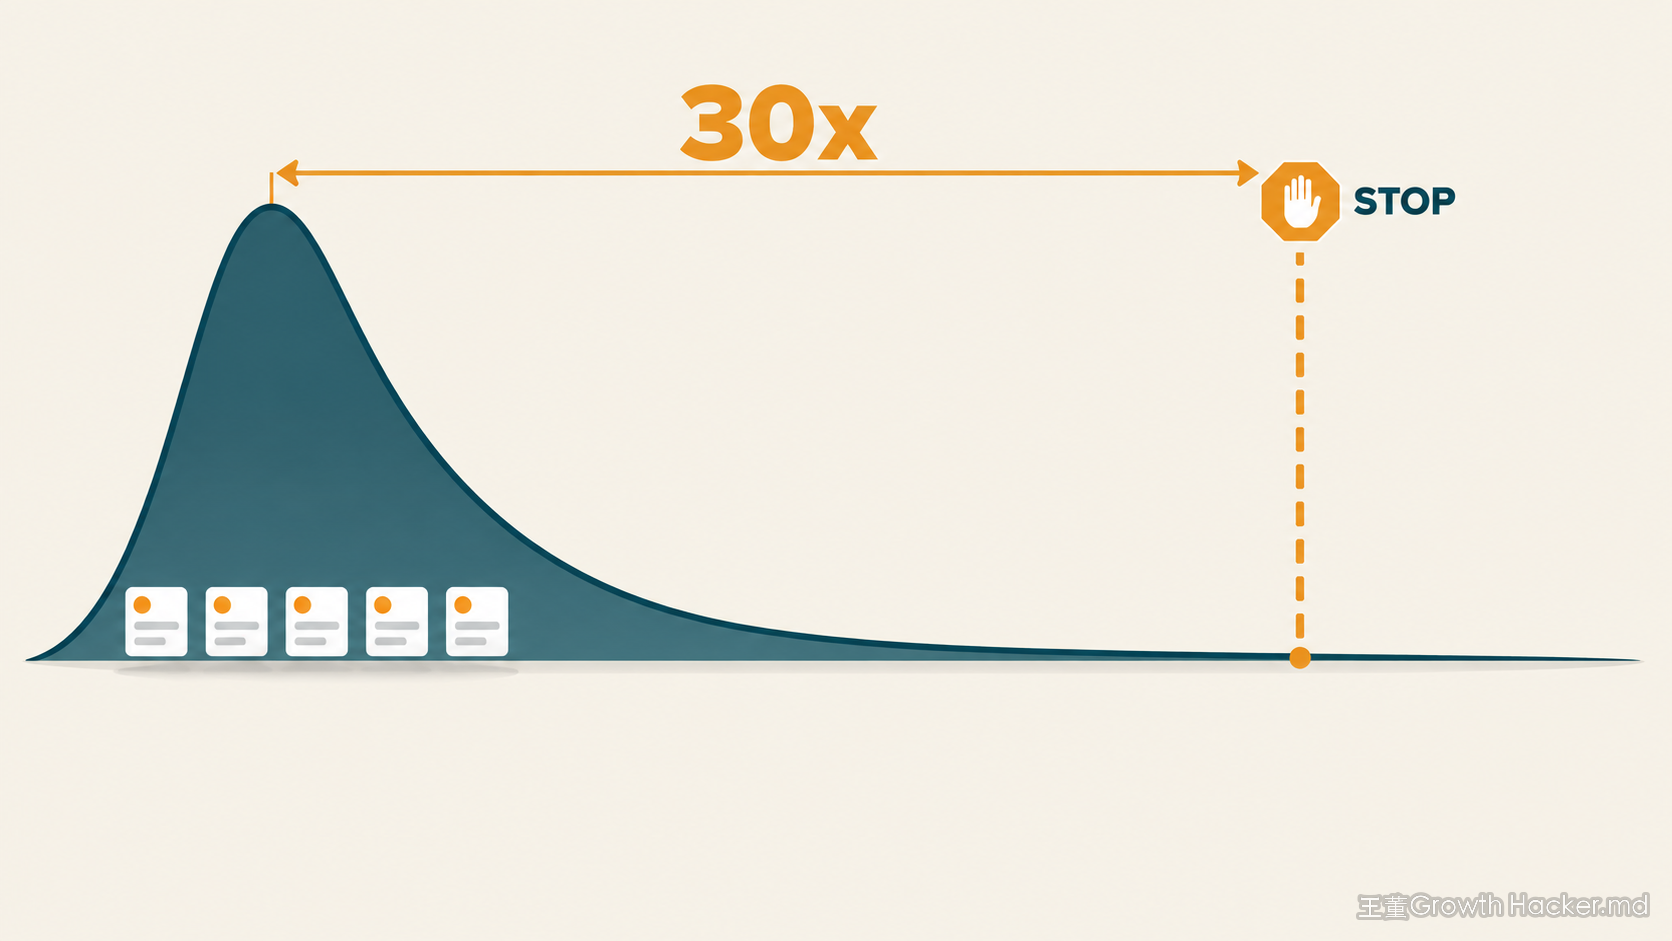
落到實務,就是幫每類任務設上限:一張客服單最多查幾次、重試幾次,超過就轉真人。我在自我改進迴圈空轉燒 token 那篇談過類似的事:沒有停損點的自動化,最後只會在報酬遞減區一直燒錢。
研討會上 Tanguy Catlin 把優化 AI 支出拆成三層(整體約 40 個槓桿):先做可視性與歸因,搞清楚哪個流程、哪個 agent、哪個模型在花錢;再做技術與流程優化,依任務難度配模型、快取可重用的脈絡、限制迴圈和工具呼叫;最後是需求與採購紀律,清掉沒在用的授權、別被單一供應商綁死。
他也特別提醒,最危險的做法是把這件事當成單純砍成本。目標是找出哪裡的 AI 支出報酬最高,再為那個報酬優化。
模型分流這件事,我在行銷 AI agent 別先接廣告帳號那篇也提過同一個架構判斷:能用規則和程式做的步驟就用程式做,模型只在需要判斷的地方出場。
AI 成本太高怎麼辦?先做這 5 件事
► 把一個 AI 流程改用「每完成一件」來記帳:模型費+驗證時間+失敗重做時間,一起算,不要只看 API 帳單
► 用公式篩任務:列出你想交給 agent 的工作,算「驗證時間 ÷ 人工時間」,門檻低於 20% 的先做,高於 50% 的先緩
► 先砍驗證時間,再談換模型:固定交件格式、寫死驗證清單,這通常比換便宜模型省得更多
► 每個 agent 設停損:最多重試幾次、單次任務成本上限多少,超過就轉人工
► 看帳單之前先看歸因:至少分得出是哪個流程、哪個模型在花錢,不然你連要優化哪裡都不知道
如果你還在找第一個流程從哪裡下手,可以先回頭看先刪掉假等待那篇,把流程裡不該存在的步驟拿掉,再來算 agent 的帳。要往公司層級的治理走,Stripe 內部 AI 助理的分層治理是很好的參考。
趨勢判斷:會被帳單卡住的,是真的在用的人
最後補一個很多人會漏看的數字。
麥肯錫的調查顯示,AI 高績效者在 coding agent 上被成本卡住的比例,大約是其他人的 3 倍。而且近四分之三的高績效者已經根本性地重新設計工作流程,其他人只有約四分之一。
換句話說,AI 帳單變貴,不一定是你做錯了,很可能是你終於開始真的在用。
差別在於,贏家會把成本攤開來看,知道每一塊錢買到了什麼。要算的帳不是 token 用了多少,而是每完成一件工作花了多少。
常見問題
AI 成本怎麼計算?
建議以「每完成一件任務」為單位計算:把模型與 token 費用、人工驗證時間、失敗後重做的時間與錯誤代價、固定成本分攤加總,再除以完成件數。麥肯錫的研究指出,在銀行客服 agent 的案例中,token 只占變動成本的 20-25%,人工監督占 70-75%。
AI 成本太高,先從哪裡降?
先把一類任務的成本拆成模型費、人工驗證、失敗重做、異常重試四塊,優先處理占比最高的那一塊。很多流程最大的一塊是人工驗證,固定交件格式和驗證清單通常比換便宜模型更有效。
為什麼 AI 越來越便宜,企業的 AI 帳單卻變高?
同等能力的推論單價確實大幅下跌,但 agent 的 token 用量成長得更快:麥肯錫估計 agentic 任務的 token 用量約為一般聊天的 1,000 倍,而且麥肯錫引用的數據顯示約六成成本與修正答案有關。
什麼情況下值得把工作交給 AI agent?
麥肯錫資深合夥人 Lari Hämäläinen 在研討會中提出簡化判斷法:當 agent 成功率明顯高於「驗證時間 ÷ 人工執行時間」,就值得交給 agent。例如人工 1 小時、驗證 6 分鐘,門檻是 10%。
用便宜的 AI 模型比較省嗎?
不一定。便宜模型若成功率較低,失敗後的人工重做與錯誤修復成本,常常超過省下的模型費。麥肯錫的 Tanguy Catlin 在研討會中表示,為了省錢選便宜模型常是錯誤取捨。
協作聲明與免責
這篇文章由王董與 AI 一起整理製作完成。文中引用的第三方資料、研究或工具都會標註來源名稱;若原始出處有公開連結,會以 [來源名稱](URL) 形式附上,方便你進一步查找。若文中內容與原始出處有任何出入,請以原文為準。
內容僅供參考與學習交流,不構成任何專業、商業或投資建議,請依自身情況判斷並自行承擔行動風險。文中提及的工具功能、數據與平台政策可能隨時間異動,請以各官方最新公告為準。